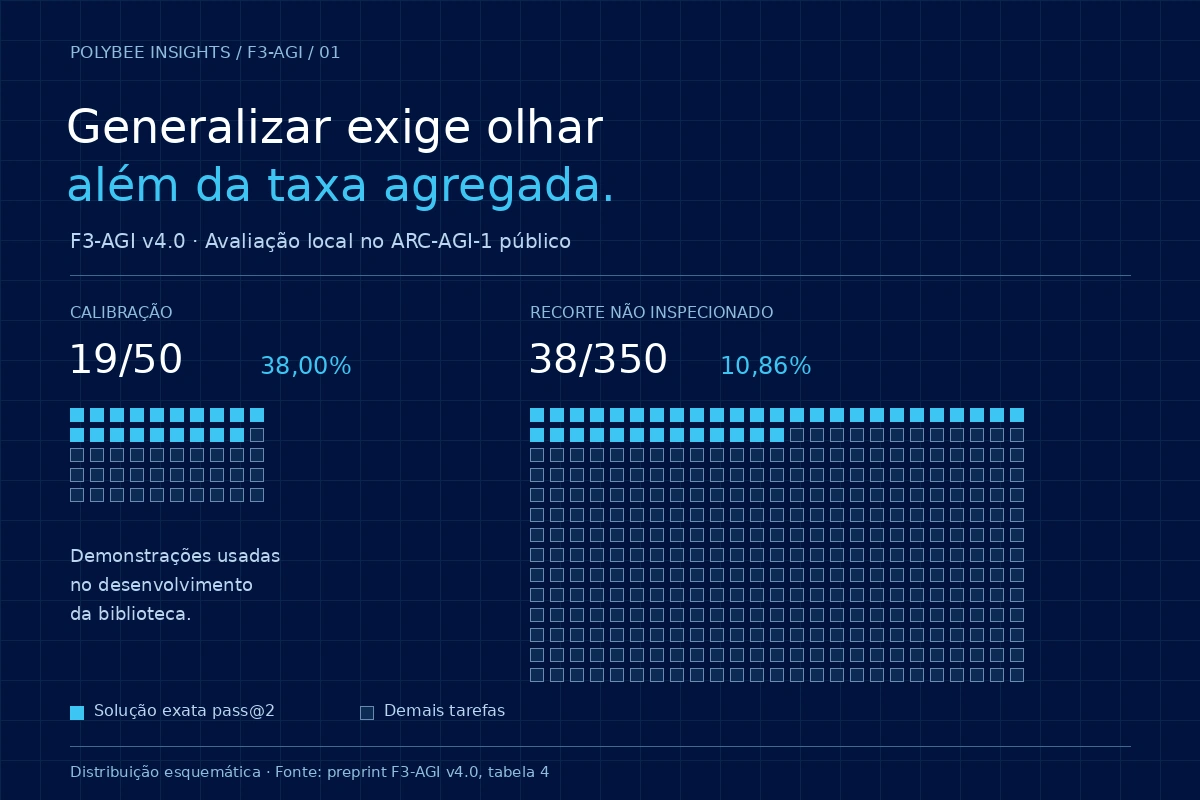
Uma regra pode explicar todas as demonstrações e ainda falhar na próxima entrada. Partindo do F3-AGI v4.0, examinamos por que essa ambiguidade exige mais do que buscar programas: ela exige representações adequadas, critérios de seleção e um protocolo que separe desenvolvimento de avaliação. Os 57 acertos em 400 tarefas precisam ser lidos junto aos dois recortes que compõem o resultado.
1. Dois exemplos podem sustentar regras incompatíveis
Imagine que um sistema observa dois pares: 1 → 2 e 2 → 4. A regra “dobrar a entrada” parece natural. Mas a função x² − x + 2 também produz exatamente essas duas respostas. Na entrada 3, a primeira retorna 6; a segunda, 8. As duas explicam o que foi mostrado e discordam sobre o que ainda não foi observado.
Esse é um exemplo aritmético construído para este artigo, não uma tarefa ARC nem um resultado do F3-AGI. Ele isola um problema fundamental: com poucas demonstrações, o ajuste perfeito aos dados disponíveis não determina sozinho como generalizar.
Experimento didático · duas hipóteses
Os mesmos exemplos. Previsões diferentes.
Demonstrações disponíveis: 1 → 2 e 2 → 4.
Saída:
Saída:
Em x = 3, as hipóteses divergem. Sem outra evidência, as duas continuam compatíveis com as demonstrações 1 → 2 e 2 → 4.
Simulação matemática ilustrativa, executada no navegador. Não chama o F3-AGI nem mede seu desempenho.
Se recebermos uma terceira demonstração, 3 → 6, a hipótese B será descartada. Isso ainda não torna a regra A a única função possível: outras expressões podem coincidir nos três pontos e divergir depois. O sistema precisa de critérios adicionais para escolher, como restrições sobre o tipo de transformação, composição de conceitos e simplicidade relativa ao seu vocabulário.
Essa escolha é um compromisso de modelagem. Uma preferência por programas curtos pode ser útil, mas o programa mais curto depende das operações disponíveis. “Curto” em uma biblioteca com uma primitiva especializada pode ser “longo” em outra. O tamanho da expressão, sozinho, não certifica que ela capturou a regra pretendida.
2. O que o ARC acrescenta a esse problema
No ARC-AGI-1, cada tarefa apresenta grades de entrada e saída para demonstração e novas entradas para teste. Construir a solução inclui escolher as dimensões da grade e preencher corretamente todas as células. O repositório oficial separa 400 tarefas de treinamento e 400 de avaliação e orienta que o segundo conjunto não informe ajustes do algoritmo durante o desenvolvimento. Seu README descreve três tentativas na interface original; o F3-AGI reporta separadamente pass@1 e pass@2 em seu próprio protocolo de avaliação local. [1]
Há duas escalas de “treino” que precisam ser diferenciadas. As demonstrações de uma tarefa são evidência legítima para inferir sua transformação durante a resolução. Já o conjunto de desenvolvimento do sistema serve para escolher operadores, hiperparâmetros e estratégias de busca. Se exemplos de uma tarefa influenciam manualmente essas decisões, a tarefa participa do desenvolvimento, mesmo que suas saídas de teste permaneçam ocultas.
Em On the Measure of Intelligence, François Chollet distingue a habilidade exibida em tarefas da eficiência para adquirir novas habilidades, destacando o papel do conhecimento prévio e da experiência. Essa perspectiva oferece uma pergunta útil para a leitura de resultados: quanto da competência veio de uma regra inferida na hora, e quanto já estava incorporado no sistema? [2]
Isso não exige eliminar todo conhecimento prévio. Um sistema precisa de uma representação para reconhecer objetos, relações e transformações possíveis. O que se exige é tornar esse repertório visível e controlar quais informações entraram nele. Caso contrário, uma melhora de pontuação pode misturar avanços na inferência com uma adaptação específica ao conjunto usado como referência.
3. Programas como hipóteses: onde está a vantagem e onde está o limite
Uma biblioteca de operações simbólicas permite escrever hipóteses como composições verificáveis. Em vez de apenas produzir uma grade final, o sistema pode representar uma transformação como uma sequência: identificar componentes, selecionar um objeto, aplicar uma relação espacial e construir a saída. Essa sequência torna algumas decisões mais fáceis de inspecionar.
Lake e colaboradores defendem que composição, modelos causais e aprender a aprender são caminhos relevantes para sistemas que adquiram conhecimento com poucos exemplos. O argumento ajuda a situar o interesse por representações estruturadas; ele não constitui uma validação do F3-AGI nem demonstra que qualquer arquitetura simbólica alcance aprendizagem humana. [3]
O DreamCoder é um exemplo concreto de outra linha de pesquisa em aprendizagem de programas: combina uma linguagem de conceitos com redes que guiam a busca e um ciclo que expande abstrações reutilizáveis. A relação com nossa discussão é conceitual: a linguagem de hipóteses também pode ser objeto de aprendizagem. Não realizamos aqui uma comparação experimental entre DreamCoder e F3-AGI. [4]
A vantagem da biblioteca vem acompanhada de um limite: o sistema só pode explorar o que consegue expressar ou construir a partir de suas operações. Se o conceito necessário não está representado e não pode ser descoberto pela composição disponível, mais busca pode apenas percorrer repetidamente um espaço inadequado.
Para quem desenvolve, isso cria duas falhas diferentes. Na primeira, uma solução expressável existe, mas a busca não a encontra dentro do orçamento. Na segunda, a solução pretendida não é expressável no repertório atual. Aumentar tempo de execução pode ajudar a primeira; enfrentar a segunda exige mudar a representação ou aprender novas abstrações. Um diagnóstico útil deve procurar distinguir esses casos.
4. Como o F3-AGI organiza a busca
No estudo estático, o F3-AGI v4.0 combina invariantes perceptuais, uma biblioteca paramétrica de 30 operadores, rejeição antecipada de candidatos incompatíveis e um mecanismo de síntese de correções residuais. A execução reportada é offline, em CPU e sem chamadas a LLMs. A descrição completa está no registro institucional e no preprint. [5]
Extrair estrutura
Organizar informação das demonstrações para restringir transformações candidatas.
Testar composições
Explorar a biblioteca e rejeitar candidatos que não atendem às condições verificadas.
Investigar o residual
Procurar patches locais quando uma transformação global está próxima da saída demonstrada.
A checagem no menor par de demonstração busca reduzir trabalho computacional antes de avaliar candidatos em todos os pares. O benefício é operacional: gastar menos tempo com hipóteses incompatíveis. Ela não transforma uma hipótese sobrevivente em solução correta para toda entrada futura.
A mesma cautela vale para o critério de seleção. Restrições estruturais e de complexidade podem reduzir candidatos espúrios, mas não eliminam a insuficiência de evidência. A seleção final ainda precisa escolher entre programas que podem coincidir nas demonstrações. O desempenho no teste é justamente onde essa escolha passa a ser examinada.
Os três estudos do preprint também devem permanecer separados. O ensaio de aprendizagem contínua usa um fluxo sintético; a avaliação estática usa tarefas públicas do ARC-AGI-1; a exploração interativa usa jogos locais inspirados no ARC-AGI-3. O resultado de um estudo não deve ser transferido automaticamente aos outros. Aqui, nosso foco é a generalização no estudo estático.
5. Por que 57/400 precisa vir acompanhado de 19/50 e 38/350
O resultado agregado de 14,25% pass@2 é correto como descrição das 400 tarefas avaliadas. Ele reúne, porém, dois recortes com histórias metodológicas diferentes. As demonstrações das primeiras 50 tarefas participaram do desenvolvimento da biblioteca: o manuscrito relata dez novos operadores construídos após inspeção de casos desse recorte. As outras 350 tarefas são descritas pelo autor como estritamente não inspecionadas. [5]
| Condição | Primeira tentativa | Até duas tentativas | O que mede neste estudo |
|---|---|---|---|
| 50 tarefas de calibração | 19/50 · 38,00% | 19/50 · 38,00% | Desempenho no recorte que informou o desenvolvimento. |
| 350 tarefas não inspecionadas | 37/350 · 10,57% | 38/350 · 10,86% | Generalização reportada após esse desenvolvimento. |
| 400 tarefas no total | 56/400 · 14,00% | 57/400 · 14,25% | Agregado dos dois recortes, não uma condição homogênea. |
O número de 38% mostra que o repertório desenvolvido resolve parte das tarefas que ajudaram a orientar seu desenho. O número de 10,86% pergunta algo diferente: quanto esse repertório transfere para tarefas que, segundo o protocolo relatado, não foram inspecionadas? Publicar ambos impede que uma medida de desenvolvimento ocupe o lugar de uma medida de transferência.
A diferença entre as taxas não permite, por si só, atribuir uma causa única ao desempenho. Os recortes não são uma comparação pareada da mesma população em duas condições controladas. Composição das tarefas, vocabulário de operadores e decisões de desenvolvimento podem contribuir. Tratar a distância como estimativa causal de “quanto o sistema memorizou” seria ir além da evidência disponível.
Outro cuidado é distinguir documentação pública de auditoria independente. O repositório disponibiliza resultados por tarefa e permite examinar a contagem, mas este ensaio é escrito pelo autor do estudo. A verificação de ausência de inspeção prévia e a reprodução em novos contextos exigem evidência adicional. O caminho mais forte para uma próxima avaliação é congelar a versão e testar um conjunto que não tenha informado novas decisões. [6]
6. Quando 99% dos pixels ainda significam uma tarefa errada
Considere outra ilustração, também hipotética: uma grade com 100 células, 99 de fundo e uma célula colorida que precisa ser colocada no local correto. Um programa que devolve apenas o fundo pode acertar 99% das células e falhar completamente na relação que define a tarefa. A precisão por pixel reconhece a sobreposição visual, mas não certifica a transformação pretendida.
O critério de acerto exato do ARC exige a grade correta, inclusive suas dimensões. No F3-AGI, o preprint reporta 57/400 soluções exatas pass@2 e, em uma medida diferente, 128/400 tarefas com pelo menos 90% de precisão por pixel no teste. Esses indicadores não são intercambiáveis e não devem ser somados. O segundo pode ajudar a localizar falhas; o primeiro estabelece quais tarefas foram efetivamente resolvidas no protocolo. [1] [5]
A seleção por simplicidade também encontra um limite nesse exemplo. “Preencher tudo com o fundo” é um programa muito curto. Se o critério de ajuste recompensa principalmente o fundo dominante, uma preferência adicional por programas curtos pode favorecer exatamente a solução degenerada. É necessário que representação, ajuste e penalização de complexidade sejam examinados em conjunto.
O contraste entre pass@1 e pass@2 acrescenta outra informação. No conjunto completo, a segunda tentativa trouxe apenas uma solução exata adicional. O manuscrito reconhece que esse resgate veio de diversidade incidental de candidatos, não de uma calibração sistemática da segunda posição. O ganho de uma tentativa extra não deve ser apresentado como evidência de um ranking confiável de hipóteses. [5]
Uma análise de erros mais útil preserva essas distinções: dimensão errada, objeto errado, relação espacial errada, transformação global correta com detalhe local incorreto ou candidato adequado mal ranqueado. Uma única média de precisão esconde quais desses problemas dominam o sistema.
7. Um patch corrige o erro ou aprende uma exceção?
O mecanismo de correção residual procura completar uma transformação global que já está próxima da solução. O estudo atribui sete soluções no recorte não inspecionado ao Cycle-3. Esse é um resultado relevante para investigar reparo local, mas a contagem não responde sozinha se a correção capturou uma relação geral ou uma regularidade mais estreita. [5]
Uma hipótese de patch pode ser compatível com todas as demonstrações e ainda depender de detalhes acidentais: tamanho de um objeto, posição de uma borda ou combinação particular de elementos. A questão volta à ambiguidade do início, agora dentro de uma etapa de correção.
Propomos que uma avaliação futura registre o programa antes do patch, a correção aplicada e o comportamento nos casos em que a mesma relação aparece com outra configuração. A unidade de análise seria o par “transformação global + patch”, preservando tanto os sucessos quanto as regressões. Esse protocolo ainda não é um resultado do estudo.
Testes contrafactuais podem ajudar, desde que respeitem a semântica da tarefa. Renomear cores consistentemente pode ser uma transformação válida quando a regra depende apenas de relações entre cores; pode ser inválida quando uma cor específica tem significado próprio. Rotacionar uma entrada também não preserva automaticamente a tarefa. Antes de testar invariância, é necessário justificar qual relação deveria permanecer igual e qual saída seria esperada.
Esses testes não substituem tarefas novas, mas podem revelar dependências ocultas em uma explicação que parecia correta. Seu valor está em formular maneiras de refutar a hipótese, em vez de acumular apenas exemplos favoráveis.
8. Como transformar a discussão em uma avaliação mais forte
Publicar código torna a inspeção possível. Para transformar essa abertura em evidência cumulativa, também precisamos de um protocolo que limite decisões posteriores ao resultado. A proposta abaixo é um roteiro para próximas rodadas, não uma alegação de que todas essas etapas já foram executadas no F3-AGI.
- Congelar o artefato.
Registrar commit, versão da biblioteca, dependências, parâmetros e orçamento de execução antes de abrir o novo conjunto. Se houver alteração, tratá-la como outra condição experimental.
- Separar os canais de informação.
Distinguir tarefas usadas para construir o sistema, tarefas usadas para escolher parâmetros e tarefas reservadas para avaliação. Registrar também a inspeção humana, não apenas o treinamento automatizado.
- Separar inferência de correção.
Gerar previsões usando demonstrações e entradas de teste. Só depois comparar com as saídas esperadas em uma etapa de avaliação que não modifique o programa candidato.
- Explicitar o orçamento.
Manter condições comparáveis de tentativas, tempo, memória, busca e chamadas externas. Publicar o que ocorreu quando o orçamento terminou, inclusive tarefas sem resposta.
- Guardar evidência por tarefa.
Registrar candidatos escolhidos, saída produzida, acerto exato, diagnóstico de erro e tempo. Uma planilha agregada não substitui o histórico necessário para entender cada falha.
- Testar robustez das conclusões.
Quando houver componentes estocásticos, executar sementes adicionais. Repetir medidas de tempo, documentar hardware e investigar se uma melhora persiste em novos conjuntos e em ablações apropriadas.
A versão atual tem um ponto concreto de partida: um release identificado, implementação, configurações e registros públicos. Esses materiais permitem formular perguntas reproduzíveis. O release v4.0.0 e o DOI do software são referências do artefato; não substituem revisão por pares ou confirmação independente. [7]
Uma comparação futura com outro solver também precisará declarar a população avaliada e o mesmo orçamento. Não basta colocar lado a lado taxas obtidas em conjuntos distintos, nem comparar uma execução local sem LLMs com um sistema que recebe outra quantidade de computação. O resultado útil descreve quais capacidades mudam sob condições comparáveis.
9. O próximo avanço precisa sobreviver a uma nova pergunta
O F3-AGI v4.0 fornece uma arquitetura examinável e resultados iniciais em contextos delimitados. Para esta discussão, a contribuição mais fértil é tornar visível a ligação entre vocabulário, busca e avaliação: uma biblioteca pode reduzir o espaço de hipóteses, mas seu desempenho depende tanto do que ela expressa quanto de como foi construída.
A próxima rodada deveria investigar pelo menos três frentes: transferência para tarefas que não orientaram o desenvolvimento; capacidade de distinguir falha de busca de limite de representação; e estabilidade das correções residuais sob mudanças semanticamente justificadas. São perguntas de pesquisa, não resultados antecipados.
Para a comunidade, propomos olhar uma solução candidata como uma explicação refutável. Qual evidência a sustenta? Em que situação ela deveria falhar? O que precisaria acontecer para abandonar o operador, o patch ou o ranking usado? Essas perguntas ajudam a transformar uma boa demonstração em um programa de investigação.
Os materiais estão disponíveis para essa discussão. Na página institucional do F3-AGI, reunimos resumo científico, preprint, DOI do software e código. Comentários sobre casos de falha e reproduções são particularmente úteis quando incluem a versão usada, o protocolo e as saídas observadas.
Perguntas que continuam a conversa
Aprender a partir das demonstrações de uma tarefa conta como vazamento de avaliação?
Não por si só. As demonstrações são parte da informação oferecida para resolver a tarefa. O problema surge quando tarefas reservadas para avaliar o sistema informam seu desenvolvimento, sua seleção de parâmetros ou ajustes manuais que depois são tratados como se não tivessem recebido essa informação.
Por que o recorte de 350 tarefas tem papel central na análise?
Segundo o protocolo reportado, suas tarefas não foram inspecionadas durante o desenvolvimento dos operadores. Por isso, o resultado de 38/350 é a medida de transferência relevante após a calibração nas primeiras 50. Essa condição reportada ainda pode ser examinada por reprodução e avaliação independentes.
A execução sem chamadas a LLMs demonstra superioridade sobre modelos de linguagem?
Não. Ela descreve a condição computacional do experimento. Uma afirmação de superioridade exigiria comparação controlada de tarefas, orçamento, conhecimento prévio e critérios de sucesso. O artigo não apresenta essa comparação.
Este artigo acrescenta novos resultados ao preprint?
Não. O texto analisa os resultados já reportados, usa exemplos didáticos próprios e propõe avaliações futuras. Não houve nova execução de benchmarks para produzi-lo.
Fontes e referências
Literatura e documentação consultadas em 30 de outubro de 2026. Os resultados do F3-AGI são os reportados no preprint e nos registros do autor; não executamos uma nova rodada de benchmarks para este ensaio. Exemplos didáticos, interpretações e propostas de avaliação estão identificados no texto.
- François Chollet / ARC-AGIARC-AGI-1 — dados, formato e orientação de avaliação
Fonte primária para os conjuntos públicos, a informação fornecida por tarefa e o critério de solução exata. O README original descreve três tentativas; o F3 reporta pass@1 e pass@2 no seu protocolo local.
- François CholletOn the Measure of Intelligence
Preprint de 2019. Contexto sobre eficiência de aquisição de habilidades, conhecimento prévio e experiência; não é validação do F3-AGI.
- Brenden M. Lake, Tomer D. Ullman, Joshua B. Tenenbaum e Samuel J. GershmanBuilding Machines That Learn and Think Like People
Versão arXiv de 2016. Discussão sobre composição, modelos causais e aprender a aprender.
- Kevin Ellis e colaboradoresDreamCoder: Growing generalizable, interpretable knowledge with wake-sleep Bayesian program learning
Preprint de 2020. Exemplo de aprendizagem de linguagens e abstrações para síntese de programas. Não há comparação experimental com o F3 neste artigo.
- Henrique Oliveira / Polybee AI ResearchF3-AGI v4.0 — manuscrito completo
Preprint de 29/10/2026, sem revisão por pares. Em especial: seção 5.2, tabela 4 e seção 6. Publicação no arXiv pendente de endosso.
- Polybee AI ResearchRegistros por tarefa — benchmark_h5_full400_eval.json
Resultados da avaliação local das 400 tarefas, incluindo 56 acertos pass@1, 57 pass@2 e tempos observados. Registros produzidos pelo autor do estudo.
- Polybee AI ResearchF3-AGI v4.0 — Initial Research Release
Release do software de 30/10/2026. DOI do artefato v4.0.0: 10.5281/zenodo.23816665; não é um identificador arXiv do manuscrito.