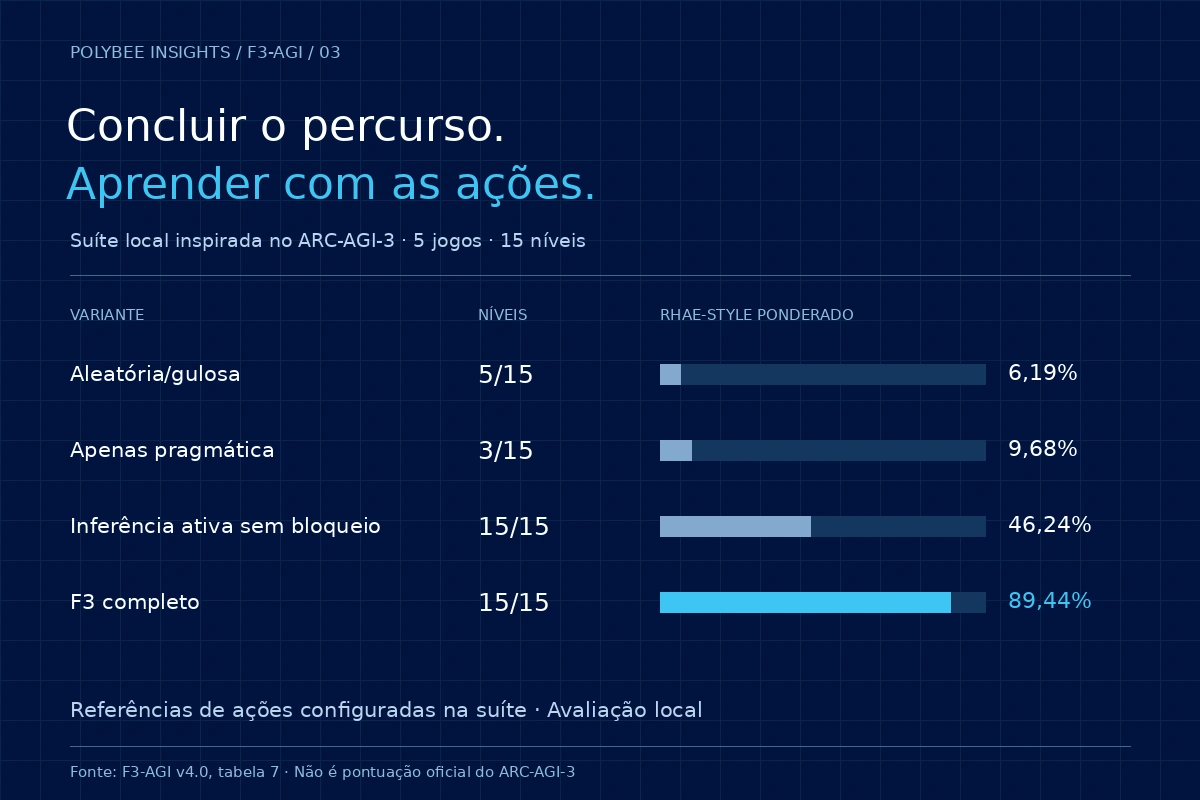
Na suíte local de cinco jogos inspirada no ARC-AGI-3, o F3-AGI v4.0 concluiu 15 de 15 níveis com 87 ações e 89,44% de eficiência ponderada RHAE-style. A conclusão completa não significa eficiência perfeita, nem pontuação oficial do benchmark. Examinamos o papel da informação na escolha de ações, o alcance das comparações publicadas e as condições em que bloquear uma tentativa aparentemente inútil pode ajudar ou prejudicar.
1. Uma ação também pode ser uma pergunta
Considere um labirinto em que uma porta bloqueia o caminho até a saída. Aproximar-se fisicamente do objetivo parece uma boa estratégia, até que o agente encontra a barreira. Um desvio até um interruptor pode aumentar a distância por alguns passos e ainda ser a melhor decisão para concluir o percurso.
Agora suponha que o agente não saiba se o objeto é um interruptor ou apenas decoração. Clicar nele pode produzir informação sobre uma relação entre objetos. Mesmo que a tentativa não abra a porta, ela pode restringir hipóteses. O valor da ação depende do que ela muda no ambiente e do que ensina ao agente sobre as possibilidades disponíveis.
Essa situação ilustra uma distinção útil entre valor pragmático, associado a resultados desejados, e valor epistêmico, associado à redução de incerteza. O trabalho de Friston e colaboradores formaliza essa relação em inferência ativa, por meio da energia livre esperada. Ele oferece um contexto teórico para discutir exploração e utilização do conhecimento. [1]
A passagem da teoria para uma implementação exige escolhas: quais estados são representados, quais resultados têm preferência, como o futuro é previsto e como se estima informação. Uma política que recompensa estados diferentes pode incentivar exploração, mas a diferença perceptual não equivale automaticamente a aprender uma regra útil.
O estudo interativo do F3-AGI fornece um ambiente delimitado para examinar algumas dessas escolhas. O interesse para a comunidade está tanto nos resultados quanto nas perguntas que sua arquitetura permite formular: quando explorar, o que guardar da tentativa e sob quais condições uma experiência passada continua relevante?
2. Quinze níveis locais: qual é o alcance da avaliação?
O experimento reúne cinco jogos em grades de 64 × 64, com três níveis por jogo e sem instruções em linguagem natural durante a interação. São cenários de interruptores e portas, empurrar blocos, alternância de cores, deslocamento com inércia e portais. A suíte foi construída localmente e é descrita no preprint como inspirada no ARC-AGI-3. [2]
O agente completo concluiu os 15 níveis em 87 ações. O código define contagens de referência que somam 80 ações para esses mesmos níveis. Embora os campos usem o nome human_baseline, o resultado publicado não representa uma nova amostra de participantes humanos recrutados e medidos para este ensaio. A interpretação disponível é uma comparação com referências configuradas na suíte. [3] [4]
Também é necessário declarar os recursos do controlador. A implementação reconhece objetos por cores e aplica regras e subobjetivos específicos. No jogo de gelo, um caminho de planejamento consulta o simulador de deslocamento do próprio ambiente. Esses recursos integram a condição experimental; o resultado não descreve descoberta irrestrita de todas as regras a partir de observações visuais. [4]
Sem instruções textuais não significa sem conhecimento prévio. Convenções de cor, estrutura das ações, funções de simulação e heurísticas incorporadas são formas de informação disponíveis ao sistema. Torná-las explícitas permite perguntar quanto da competência vem de planejar com um modelo fornecido e quanto vem de inferir um modelo desconhecido.
Essa delimitação não elimina a utilidade do teste. Uma suíte controlada pode revelar mecanismos e falhas com clareza. O cuidado é manter sua população visível: cinco famílias locais com níveis relacionados oferecem evidência sobre esse cenário. Uma afirmação de transferência para jogos novos exige um desenho adicional de avaliação.
3. O que uma representação de 512 dimensões ajuda a perceber
Para comparar observações, o sistema usa uma projeção aleatória de semente fixa em 512 dimensões, seguida de normalização L2. Essa construção é executada sem pré-treinamento de um encoder neural JEPA. A inspiração teórica e a representação efetivamente usada precisam ser descritas separadamente. [2]
A medida de cobertura de estados, denominada PairDist no trabalho, fornece um sinal para explorar observações que se afastam das já registradas. Essa distância pode funcionar como um indicador operacional de novidade. Seu significado depende da informação preservada pela representação e da relação entre mudança visual e mudança relevante para a tarefa.
Imagine duas situações hipotéticas. Na primeira, acionar um mecanismo muda discretamente o estado de uma porta e permite uma nova rota. Na segunda, um objeto decorativo alterna muitas células de cor sem afetar qualquer possibilidade de ação. Um critério puramente perceptual pode atribuir muita novidade ao segundo caso. O desafio é relacionar cobertura visual a conhecimento sobre transições e objetivos.
Também pode ocorrer o inverso: dois quadros quase iguais representam contextos diferentes porque uma chave foi adquirida, um contador avançou ou uma regra mudou. Se o estado do agente omite essa diferença, a memória de ações pode tratar como equivalentes situações que exigem comportamentos distintos.
Na literatura, a inferência ativa é um arcabouço probabilístico com hipóteses precisas sobre modelos e políticas. Da Costa e colaboradores mostram que relações com maximização de recompensa dependem da formulação e do horizonte de planejamento. Esse contexto reforça a necessidade de avaliar a implementação concreta. Uma soma de distância ao objetivo, novidade e custo exige sua própria evidência de utilidade. [5]
Para a próxima rodada, uma análise informativa compararia representações alternativas mantendo política e orçamento fixos. Além de conclusão e ações, seria útil registrar quais diferenças latentes corresponderam a novas possibilidades de ação e quais apenas refletiram alterações visuais.
4. Aprender que uma tentativa não funciona exige contexto
O mecanismo DeadSignatureTracker guarda informação sobre ações que não produziram efeito observável e permite bloquear tentativas associadas a assinaturas já reconhecidas. A motivação é simples: repetir a mesma interação improdutiva pode gastar orçamento sem acrescentar evidência. A memória ajuda a concentrar a exploração em alternativas ainda abertas.
Há, porém, diferença entre testar algo uma vez e continuar repetindo depois de conhecer o resultado. A primeira tentativa pode ser informativa: ela descarta uma hipótese sobre o objeto. O objetivo de uma memória útil é preservar esse aprendizado e reconhecer em que contexto ele continua válido. Uma contagem de “ações mortas” não mede, sozinha, o valor informativo de toda tentativa malsucedida.
Considere uma porta que não abre antes de coletar uma chave. Uma assinatura que associe globalmente “clicar na porta” a fracasso pode impedir a ação correta mais tarde. Outro caso é um comando que precisa ser repetido ou esperar uma resposta atrasada: ausência de mudança imediata não implica ausência de efeito. Esses são exemplos didáticos de possíveis falhas, ainda não novos resultados do F3.
Observar a transição
Registrar ação, contexto, mudança percebida e informação que a tentativa acrescentou.
Guardar condições
Associar a conclusão ao estado e às hipóteses sob as quais ela foi obtida.
Reabrir a hipótese
Permitir nova tentativa quando o contexto muda ou a confiança deixa de ser adequada.
Em um ambiente determinístico cujo estado relevante é totalmente representado, repetir a mesma ação no mesmo estado tende a reproduzir o resultado. Sob observação parcial ou transições estocásticas, esse raciocínio requer mais cuidado: outra tentativa pode fornecer evidência adicional ou encontrar um efeito que não ocorreu antes.
Uma extensão de pesquisa seria guardar confiança, validade temporal e condições de revisão da assinatura. Também seria necessário medir o erro de bloqueio: quantas ações produtivas foram excluídas? Eliminar repetições improdutivas é útil, mas o custo de impedir uma descoberta precisa aparecer na avaliação.
5. O que as quatro variantes mostram — e o que ainda precisa ser isolado
A comparação publicada separa uma heurística aleatória/gulosa, uma política apenas pragmática, uma configuração de inferência ativa sem bloqueio e o F3 completo. Os resultados abaixo pertencem à suíte local e aos registros do autor. Não houve reprodução independente ou nova execução para produzir este artigo. [2] [3]
| Variante | Níveis concluídos | RHAE-style ponderado | Média simples | Ações sem efeito | ATP virtual |
|---|---|---|---|---|---|
| Aleatória/gulosa | 5/15 | 6,19% | 10,11% | 82 | 4,000 |
| Apenas pragmática | 3/15 | 9,68% | 15,33% | 119 | 4,000 |
| Inferência ativa sem bloqueio | 15/15 | 46,24% | 47,17% | 32 | 2,380 |
| F3 completo | 15/15 | 89,44% | 90,72% | 0 | 1,740 |
As duas últimas variantes concluem todos os níveis. Sua diferença aparece na eficiência e nas ações sem efeito. Isso sugere investigar como a memória da interação pode reduzir trabalho depois que a capacidade de conclusão já foi alcançada. O aumento observado é de 43,20 pontos percentuais no indicador ponderado.
É preciso observar, contudo, quais componentes mudam. No código, a configuração completa ativa tanto o bloqueio de assinaturas quanto a transferência de regras entre níveis. Há ainda caminhos de política específicos para a variante sem bloqueio, incluindo tentativas iniciais em distratores. A comparação envolve esses comportamentos implementados, de modo que o ganho não pode ser atribuído integralmente a uma única variável causal. [4]
Uma ablação mais informativa manteria o mesmo gerador de ações candidatas e a mesma função de seleção em todas as condições, variando separadamente bloqueio e transferência. As quatro combinações resultantes ajudariam a medir efeitos individuais e interação entre componentes.
O número zero de ações sem efeito também precisa de contexto. Ele descreve as trajetórias da variante completa nessa suíte, com suas heurísticas e conhecimentos prévios. Um agente que aprende regras desconhecidas pode precisar de algumas tentativas negativas. O alvo científico é reduzir repetição desnecessária preservando a capacidade de descobrir regras novas.
6. Concluir tudo e marcar menos de 100% é perfeitamente possível
A conclusão de um nível é uma medida binária. A eficiência usada na suíte acrescenta uma comparação entre a quantidade de ações do agente e uma contagem de referência. Para um nível concluído, o cálculo é r = min(1, H/A)², em que H é a referência e A é o número de ações. Um nível não concluído recebe zero. [4]
Em um exemplo fictício com H = 10, concluir em dez ações produz 100%. Concluir em vinte ações produz 25%, porque a razão 10/20 é elevada ao quadrado. Concluir em menos de dez ações permanece limitado a 100%. Essa forma de pontuar penaliza excedentes de ações sem alterar o fato de o nível ter sido resolvido.
Exemplo fictício · um nível concluído
O efeito da penalização quadrática
Contagem de referência fixa: H = 10 ações.
o nível foi resolvido
min(1, 10/A)² × 100
Com 20 ações, a razão é 0,50 e o escore é 25,00%. Se o nível não fosse concluído, o escore seria zero.
Simulação da fórmula, sem executar o agente. Estes números não correspondem a um nível medido do F3.
O agregado ponderado usa pesos 1, 2 e 3 para os níveis de cada jogo. A média simples atribui a todos o mesmo peso. É por isso que 89,44% ponderado e 90,72% não ponderado podem coexistir: são agregações diferentes dos mesmos escores por nível.
Também seria incorreto calcular o indicador apenas como (80/87)² a partir dos totais da suíte. A transformação quadrática e o limite superior são aplicados por nível antes da agregação. Somar ações primeiro perde a distribuição dos excedentes e muda a operação matemática.
Esses detalhes fazem parte do resultado, não apenas de sua apresentação. Informar fórmula, condições de falha, pesos e contagens de referência permite que outra pessoa reconstrua o indicador e avalie se ele corresponde ao objetivo de uso.
7. Onde ficaram as sete ações além da referência
O total de 87 ações combina trajetórias diferentes. O F3 completo iguala as referências configuradas em três jogos. Nos outros dois, resolve todos os níveis usando mais ações. A tabela preserva essa distribuição, sem tratar a média da suíte como descrição uniforme de cada família. [2] [3]
| Jogo local | Ações | Referência | RHAE-style ponderado |
|---|---|---|---|
| SwitchAndDoorMaze | 23 | 21 | 83,47% |
| SokobanPushBlocks | 25 | 20 | 63,74% |
| ColorInfectionToggle | 12 | 12 | 100,00% |
| IceSlideInertia | 9 | 9 | 100,00% |
| TeleporterKeyPortal | 18 | 18 | 100,00% |
As duas ações adicionais do labirinto se concentram no terceiro nível: a trajetória usa 11 ações contra referência de nove. No jogo de empurrar blocos, o excedente aparece nos três níveis, com 6/9/10 ações diante de 5/7/8. Essas trajetórias fornecem casos concretos para investigar planejamento e reutilização de regras.
Zero ações classificadas como sem efeito pode coexistir com esses excedentes. Um movimento pode mudar o quadro e ainda alongar o caminho. Uma sequência pode ser produtiva localmente e levar a um desvio global. Portanto, bloquear interações inertes cobre apenas uma classe de ineficiência.
Para diagnosticar o restante, propomos decompor ações em exploração que altera crenças, deslocamentos necessários, desvios recuperáveis e decisões que tornam uma meta impossível. Essa classificação exige critérios previamente definidos e, idealmente, revisão das trajetórias. O estudo atual fornece contagens; a nova decomposição seria uma análise adicional.
Uma pergunta prática segue daí: o mecanismo aprende quando parar de explorar? Transferir uma regra pode reduzir tentativas repetidas, mas uma regra incorreta pode sustentar uma rota ruim. A qualidade da memória precisa ser medida junto com a quantidade de ações economizadas.
8. Como testar se a estratégia transfere além da suíte
Propomos uma próxima avaliação organizada em torno das hipóteses que podem quebrar o mecanismo. O roteiro abaixo não descreve experimentos já executados no F3. Ele busca separar descoberta de regras, uso de modelos fornecidos e transferência entre contextos.
- Congelar o controlador antes de abrir jogos novos.
Reservar famílias que não tenham informado heurísticas, cores ou rotas. Documentar se há acesso ao simulador, a estados internos ou somente aos quadros e ações da interface.
- Separar bloqueio de transferência.
Executar as quatro combinações dos dois componentes com a mesma política de base. Publicar trajetórias, múltiplas sementes quando aplicáveis e custo computacional por decisão.
- Alterar convenções preservando a tarefa.
Quando cores não tiverem significado intrínseco, permutá-las consistentemente; mudar posições e tamanhos dentro de regras válidas. Verificar se o desempenho depende de convenções reconhecidas no código.
- Introduzir dependências temporais.
Testar efeitos atrasados, comandos repetidos necessários, mudanças de regras e transições estocásticas. Medir ações úteis bloqueadas e recuperação depois de uma hipótese incorreta.
- Documentar a referência de eficiência.
Explicar como cada contagem de referência foi obtida, qual informação estava disponível e como falhas são pontuadas. Caso haja participantes humanos, relatar o protocolo e sua variação.
- Avaliar transferência negativa.
Construir níveis em que uma regularidade anterior deixe de valer. Medir quanto tempo o agente leva para revisar a memória e quanto a transferência ajuda ou atrapalha diante da mudança.
Uma avaliação assim pode produzir um resultado menos uniforme e mais informativo. Se o bloqueio funcionar apenas quando todos os estados relevantes são visíveis, teremos identificado uma condição de validade. Se a transferência resistir à troca de convenções, haverá evidência mais forte de que a regra armazenada capturou relações úteis.
Também será importante separar ações no ambiente de computação interna. Um agente pode reduzir cliques usando muito mais simulação e busca. Para escolher uma arquitetura, precisamos conhecer ambos os custos e o orçamento disponível por decisão.
9. Agentes melhores precisam saber revisar o que acreditam
A suíte local do F3-AGI v4.0 oferece resultados iniciais sobre uma combinação de exploração, planejamento e memória. O sistema completo concluiu todos os níveis e apresentou maior eficiência que as variantes comparadas. A interpretação científica desse ganho depende das regras incorporadas, do acesso ao ambiente e dos componentes que mudaram juntos.
O princípio de engenharia que emerge é tratar uma ação como uma intervenção acompanhada de evidência. O agente precisa registrar o que tentou, o que mudou, o que isso permite inferir e quando essa inferência deve ser revista. Essa organização ajuda a transformar uma repetição automática em uma decisão que pode ser examinada.
A trilogia se conecta nesse ponto. O primeiro artigo discute regras compatíveis com poucos exemplos; o segundo, a seleção de mudanças nos parâmetros; este, a seleção de intervenções no ambiente. Em cada caso, o desafio é fazer escolhas sob evidência limitada e avaliar quando uma economia preserva a capacidade necessária.
Para a comunidade, os próximos avanços serão mais claros quando vierem acompanhados de trajetórias, condições de acesso e casos em que a memória falha. Na página institucional da pesquisa, reunimos o preprint e os artefatos para essa investigação. Reproduções e contrapontos documentados são uma forma concreta de ampliar o que podemos concluir a partir dos resultados atuais.
Perguntas que continuam a conversa
89,44% é uma pontuação oficial do ARC-AGI-3?
Não. É o indicador RHAE-style ponderado calculado em uma suíte local de cinco jogos e quinze níveis inspirada no ARC-AGI-3. A população avaliada, as referências e o acesso do controlador pertencem a esse experimento local.
Como 100% de conclusão pode coexistir com 89,44% de eficiência?
Conclusão mede quais níveis foram resolvidos. O indicador de eficiência também penaliza ações além das referências configuradas e agrega os escores por nível com pesos 1, 2 e 3. Resolver todos os níveis não exige igualar essas contagens.
Bloquear ações sem efeito sempre é uma boa estratégia?
Sua utilidade depende do estado representado e da dinâmica. Uma ação pode ter efeito atrasado, depender de uma chave ou produzir resultados estocásticos. Uma regra de bloqueio precisa reconhecer mudanças de contexto e permitir revisão.
A projeção de 512 dimensões é um modelo JEPA pré-treinado?
Não. A implementação descrita usa projeção aleatória fixa e normalização L2. A medida de cobertura de estados é um proxy operacional de exploração; sua relação com descoberta de regras precisa ser testada.
O ganho de eficiência pode ser atribuído somente ao DeadSignatureTracker?
A comparação publicada também muda transferência entre níveis e caminhos da política. Uma avaliação que varie esses componentes separadamente, com a mesma base de seleção de ações, é necessária para isolar suas contribuições.
Fontes e referências
Literatura e documentação consultadas em 30 de outubro de 2026. Os resultados do F3-AGI são os reportados no preprint e nos registros do autor; não executamos uma nova rodada de benchmarks para este ensaio. Exemplos didáticos, interpretações e propostas de avaliação estão identificados no texto.
- Karl Friston, Francesco Rigoli, Dimitri Ognibene, Christoph Mathys, Thomas Fitzgerald e Giovanni PezzuloActive inference and epistemic value
Artigo de 2015. Contexto primário para a relação entre valor extrínseco e epistêmico na energia livre esperada. Não valida a implementação F3.
- Henrique Oliveira / Polybee AI ResearchF3-AGI v4.0 — preprint
Manuscrito de 29/10/2026, sem revisão por pares. Seções 3.3 e 5.3, tabelas 6 e 7. A avaliação interativa é local e inspirada no ARC-AGI-3.
- Polybee AI Researchbenchmark_h3_arc3_ablation.json — release v4.0.0
Registros de ações, conclusão e eficiência por jogo e variante. Campos com o nome official_rhae_pct não transformam esses resultados locais em pontuação oficial.
- Polybee AI Researchf3_agi_v4_arc3_runner.py — implementação v4.0.0
Fonte para referências de ações, fórmula de agregação e políticas. Inclui heurísticas por cor, diferenças entre variantes e uso de simulador no jogo de gelo.
- Lancelot Da Costa, Noor Sajid, Thomas Parr, Karl Friston e Ryan SmithReward Maximisation through Discrete Active Inference
Versão arXiv revisada em 2022. Contexto sobre condições formais da relação entre inferência ativa e políticas ótimas de recompensa.
- Polybee AI ResearchF3-AGI v4.0.0 — Initial Research Release
Artefato versionado para consulta e reprodução. DOI do software: 10.5281/zenodo.23816665. A publicação do manuscrito no arXiv aguarda endosso.