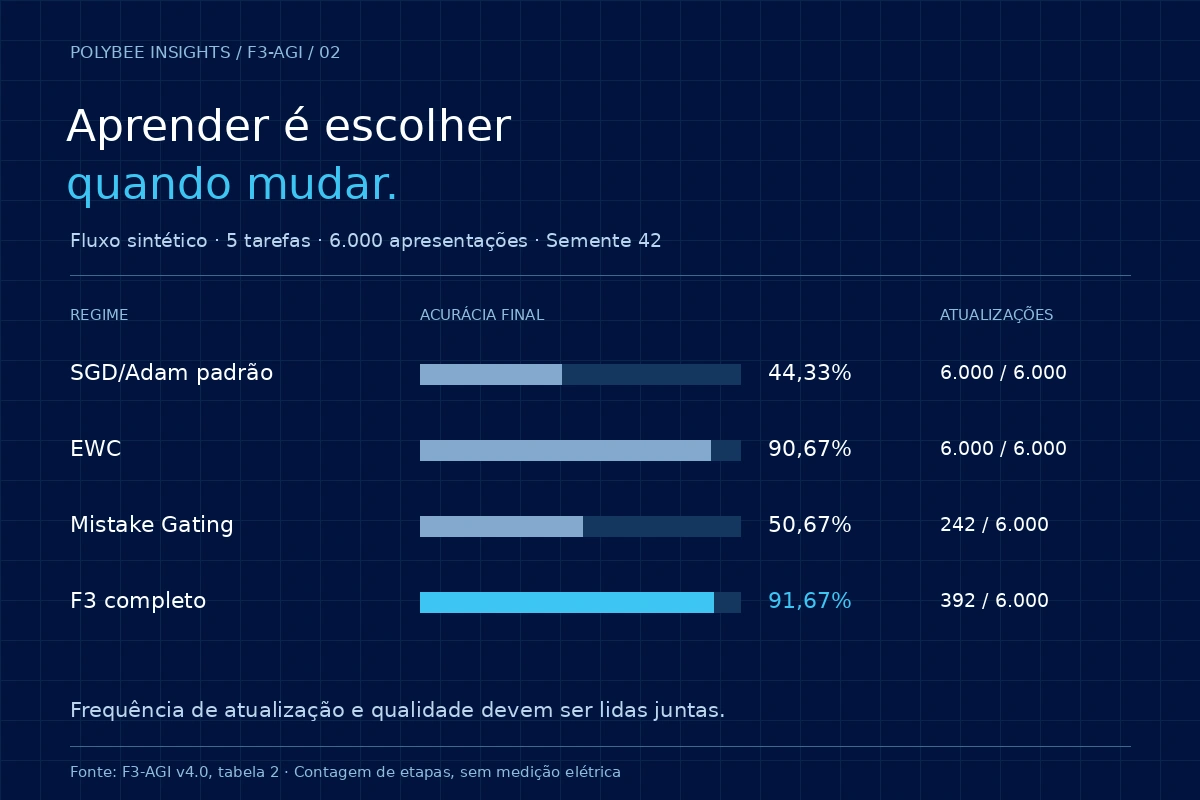
No experimento sintético do F3-AGI v4.0, o regime completo preservou 91,67% de acurácia média final executando 392 atualizações em 6.000 apresentações. O resultado abre uma discussão sobre aprendizagem seletiva: poupar mais atualizações, isoladamente, não garantiu melhor memória. Para avaliar eficiência, precisamos observar a qualidade retida, a frequência das mudanças, sua magnitude e o custo real de executar todo o sistema.
1. Aprender uma coisa nova pode deslocar o que já funcionava
Imagine um classificador que aprende primeiro a distinguir dois tipos de sinal. Depois recebe um novo par de categorias e ajusta os mesmos parâmetros. Se a representação compartilhada mudar demais, decisões que funcionavam na primeira etapa podem se deteriorar. O sistema pode terminar muito competente na tarefa recente e pouco confiável nas anteriores.
Esse problema torna a acurácia da última tarefa uma descrição insuficiente. Em aprendizagem contínua, também importa saber o que permaneceu acessível depois de toda a sequência. A escolha envolve plasticidade, para incorporar informação nova, e estabilidade, para preservar competências anteriores. Uma intervenção que simplesmente congele todos os parâmetros preservará parte do passado, mas poderá impedir aprendizagem relevante.
A Elastic Weight Consolidation, ou EWC, propõe proteger parâmetros importantes para tarefas anteriores por meio de uma penalização que dificulta seu deslocamento. O trabalho de Kirkpatrick e colaboradores oferece o contexto dessa estratégia de retenção. Sua existência também lembra que preservar memória exige um mecanismo explícito e uma comparação com alternativas adequadas. [1]
O estudo de aprendizagem contínua do F3-AGI investiga outra dimensão desse compromisso: quando vale executar uma atualização? A hipótese de engenharia é que adaptar a frequência e a direção das mudanças pode preservar desempenho com menos intervenções nos pesos. Para examinar essa ideia, precisamos primeiro delimitar o cenário em que ela foi testada e o que foi efetivamente contado.
2. Um experimento controlado, com fronteiras bem definidas
A avaliação usa cinco tarefas sequenciais, cada uma com duas classes, em um espaço sintético de características de 64 dimensões. Uma rede com camadas 64 → 256 → 128 → 10 recebe 120 exemplos de treinamento por tarefa durante dez épocas: são 6.000 apresentações no total. O teste possui 60 exemplos por tarefa. A configuração publicada usa semente 42. [2] [3]
“Zero replay” significa aqui que o treinamento das novas tarefas não recupera um buffer de exemplos das tarefas anteriores. Há repetição de exemplos durante as dez épocas da tarefa corrente. Essa distinção importa: a evidência disponível não descreve um fluxo em que cada amostra é vista uma única vez, nem um sistema sem qualquer memória interna. O algoritmo mantém estatísticas e informações de consolidação.
As entradas já são vetores sintéticos construídos a partir de protótipos. O experimento não treina diretamente sobre as grades brutas do ARC, imagens naturais ou linguagem. Isso permite isolar interferência entre classes e mecanismos de atualização com custo reduzido. Ao mesmo tempo, limita a transferência imediata das conclusões para tarefas que exigem aprender a própria representação perceptual.
Há quatro regimes no registro: atualização padrão, EWC, gating de erros isolado e F3-Metabolic-Optim completo. O relatório chama a primeira condição de “SGD/Adam”; a implementação desse caminho aplica uma atualização direta proporcional ao gradiente. Por isso, tratamos os números como uma comparação entre as implementações publicadas, sem estendê-los a todos os otimizadores com esses nomes. [4]
Esse cuidado evita transformar um teste controlado em uma afirmação universal. O cenário é útil porque permite investigar uma hipótese específica. Sua força cresce quando outras condições preservam a conclusão, especialmente se alteram ordem das tarefas, ruído, tamanho da rede e distribuição dos exemplos.
3. Três decisões diferentes: atualizar, em qual direção e com qual intensidade
A primeira decisão é a porta de entrada da aprendizagem. Na implementação, a necessidade de atualização depende do erro associado à classe correta e de uma memória de exemplos problemáticos. Se o exemplo já satisfaz o critério e não permanece nessa memória, a etapa de alteração dos pesos pode ser pulada. Ainda houve passagem pela rede para produzir a previsão e avaliar a condição de gating.
A segunda decisão trata da direção da mudança. O regime completo usa estatísticas de importância dos parâmetros, pré-condicionamento e atração para pesos consolidados. A intenção é reduzir interferência em direções associadas a conhecimento anterior. Pular etapas não produz esse efeito automaticamente: quando uma atualização é executada, ela ainda pode deslocar parâmetros úteis para outras tarefas.
A terceira decisão modula a intensidade. O tensor interno chamado M influencia a atualização por uma função de controle e é ajustado ao longo da execução. A terminologia “metabólica” descreve a inspiração e a organização do algoritmo. Ela não demonstra equivalência com processos celulares nem estabelece uma conversão de seus valores para consumo de hardware. [4]
Quando mudar
O erro e sua memória orientam a execução ou o salto de uma etapa de atualização.
O que proteger
Importância histórica e pesos consolidados restringem o deslocamento dos parâmetros.
Quanto mudar
Um estado algorítmico interno ajusta a intensidade das alterações executadas.
Separar essas decisões ajuda a interpretar o resultado e a planejar ablações. Uma comparação entre quatro regimes não identifica sozinha a contribuição causal de cada termo do regime completo. Para isso, seria necessário variar os componentes mantendo os demais controles: mesma inicialização, mesmo fluxo, mesmo orçamento de ajuste e múltiplas repetições.
Também há um custo para decidir que nada será feito. Avaliar o erro, consultar memória e manter estatísticas exige trabalho. Uma contagem de etapas poupadas revela uma parte importante da execução; a contabilização total precisa incluir as operações que tornaram essa seleção possível.
4. O regime que mais pula atualizações não é o que mais retém
Os números abaixo são os resultados publicados pelo autor, sem uma nova execução para este ensaio. A acurácia é a média nas cinco tarefas depois de treinar a quinta. A coluna de esquecimento acompanha a nomenclatura percentual do relatório; no código, ela é calculada pela média das quedas, em pontos percentuais de acurácia, entre o melhor valor registrado e o valor final nas quatro tarefas anteriores. [3] [4]
| Regime publicado | Acurácia final ↑ | Esquecimento ↓ | Etapas executadas | Etapas poupadas | M1 ↓ |
|---|---|---|---|---|---|
| SGD/Adam padrão | 44,33% | 69,58 | 6.000/6.000 | 0,00% | 3.433,87 |
| EWC | 90,67% | 11,25 | 6.000/6.000 | 0,00% | 7.986,85 |
| Mistake Gating isolado | 50,67% | 61,25 | 242/6.000 | 95,97% | 3.040,31 |
| F3-Metabolic-Optim | 91,67% | 9,17 | 392/6.000 | 93,47% | 2.736,81 |
O gating isolado executa 150 etapas a menos que o F3 completo. Mesmo assim, sua acurácia média final fica em 50,67%, com maior esquecimento. Isso mostra por que maximizar a porcentagem de saltos pode escolher um regime inadequado para quem precisa preservar competência ao longo da sequência.
A comparação com EWC responde a outra pergunta. Nesta execução, o F3 chega a uma acurácia final próxima, com menos etapas e menor magnitude acumulada de mudança. A diferença de um ponto percentual na acurácia, porém, não tem um intervalo de incerteza calculado a partir de várias sementes. Ela deve permanecer como diferença observada nessa configuração.
Uma leitura por tarefa acrescenta informação que a média esconde. Ao final, o registro mostra 75% na primeira tarefa para F3 e 65% para EWC; nas demais, há variações em ambas as direções. Uma próxima avaliação deveria preservar a matriz de desempenho ao longo da sequência, permitindo localizar quando uma competência foi adquirida, esquecida ou recuperada.
5. Atualizações, M1, tempo e energia respondem a perguntas diferentes
No contador publicado, uma “atualização sináptica” corresponde a uma etapa em que os parâmetros da rede são alterados. O número 392 não conta 392 conexões individuais: cada etapa pode atualizar muitos pesos. A medida informa a frequência das intervenções em relação às 6.000 apresentações.
M1 acrescenta a magnitude dessas intervenções: M1 = Σₜ Σᵢ |Δwₜ,ᵢ|. Dois regimes podem executar o mesmo número de etapas e mover seus parâmetros em escalas muito diferentes. O F3 registra M1 de 2.736,81, ante 7.986,85 de EWC, uma redução aproximada de 65,7% nesse indicador. Esse cálculo depende da parametrização, da escala dos pesos e das alterações contabilizadas. [2]
Tempo de execução inclui outras parcelas: passagens de inferência, cálculo de gradientes, consolidação, acesso à memória e sobrecarga da implementação. Há inclusive tempos diferentes entre os artefatos publicados: a tabela 2 do manuscrito reporta aproximadamente 1,06 s para F3 e 2,32 s para EWC; o JSON do release registra 1,554 s e 5,073 s. São registros distintos, que não devem ser combinados em uma única estimativa de aceleração. [2] [3]
Energia elétrica requer medição ou estimação física documentada, com potência integrada no tempo. Emissões acrescentam ainda a intensidade de carbono da eletricidade e o escopo adotado. O debate de Strubell e colaboradores sobre custos de treinamento ajuda a justificar essa atenção, sem oferecer uma conversão pronta para o nosso experimento. [5]
O ATP virtual, por sua vez, é um estado de controle do programa. Interpretá-lo como bateria, joules ou moléculas reais criaria uma unidade que o estudo não mediu. A analogia biológica pode orientar mecanismos; a validação computacional e a validação biológica continuam exigindo seus próprios experimentos.
6. Uma conta simples mostra o papel do custo que permanece
Podemos construir uma ilustração contábil sem estimar o consumo do F3. Suponha que um processo denso custe 100 unidades normalizadas. Uma fração desse custo pertence às atualizações que podem ser evitadas; o restante permanece, incluindo operações necessárias em todas as apresentações. Assuma, apenas para este modelo, custo uniforme por etapa e ausência de sobrecarga adicional do mecanismo seletivo.
Se a parcela evitável for 20 unidades e executarmos 392/6.000 das atualizações, o custo ilustrativo será 80 + 20 × (392/6.000) ≈ 81,31. A redução total será de aproximadamente 18,69%, embora 93,47% das etapas de atualização tenham sido poupadas. A diferença vem do escopo da conta: grande parte do trabalho continua existindo.
Modelo contábil ilustrativo
Quanto do custo pode ser evitado?
Referência: 100 unidades. Fração executada das atualizações: 392/6.000.
unidades normalizadas
em relação às 100 unidades
A parcela restante é mantida constante. O modelo ignora sobrecarga de seleção, diferenças entre atualizações e efeitos do hardware.
Demonstração matemática, sem medição de energia ou execução do F3. O controle altera uma hipótese de custo, não um dado experimental.
Quando a parcela evitável se aproxima de zero, poupar atualizações tem pouco efeito no total. Quando ela domina o processo, os saltos podem ter maior impacto. O modelo ajuda a identificar o dado que falta: quanto cada parte realmente custa nas condições de uso?
Em uma implementação real, o custo por atualização também pode variar. Operações pequenas podem ocupar mal o hardware; acessos à memória podem dominar o tempo; uma seleção complexa pode consumir parte da economia esperada. Essas possibilidades precisam ser medidas. A demonstração oferece um raciocínio para desenhar a medição, sem antecipar seu resultado.
7. Como medir eficiência de ponta a ponta
Um protocolo futuro pode tratar eficiência como uma relação entre qualidade entregue e recursos consumidos. O trabalho Green AI defende incluir eficiência entre os critérios de avaliação e relatar custos computacionais. Para nossa próxima rodada, isso se traduz em um conjunto concreto de escolhas experimentais, proposto aqui pelo autor. [6]
- Definir a unidade funcional.
Por exemplo: completar a mesma sequência de tarefas preservando um nível mínimo de acurácia final. Comparar custo sem controlar qualidade pode premiar um sistema que simplesmente aprende menos.
- Fixar o escopo da execução.
Incluir geração de previsões, gating, gradientes, consolidação e avaliação quando fizerem parte do uso declarado. Publicar separadamente custo de desenvolvimento e custo de uma execução congelada.
- Registrar as condições físicas.
Identificar processador, memória, sistema, bibliotecas, número de threads, aquecimento e processos concorrentes. Informar se a medida é do processo, de um componente ou da máquina inteira.
- Medir duração e energia com repetições.
Documentar instrumento ou estimador, frequência de amostragem e tratamento do consumo em repouso. Divulgar valores brutos e dispersão, com a mesma convenção para todos os regimes.
- Manter as métricas algorítmicas.
Contar etapas, M1 e memória ajuda a explicar o comportamento. Relacionar esses indicadores às medições físicas permite testar quando funcionam como bons proxies e quando deixam de funcionar.
Esse protocolo também precisa de critérios de equivalência. Se um regime alcança a qualidade necessária com menos treinamento, comparar apenas uma duração fixa pode esconder sua vantagem. Se outro depende de um ajuste extenso de hiperparâmetros, ignorar esse processo esconde parte do custo de obtê-lo. Convém relatar ambos os recortes, com fronteiras explícitas.
8. As situações em que a seleção pode falhar são parte da hipótese
Um exemplo que parece resolvido hoje pode voltar a exigir aprendizagem depois de uma mudança de distribuição. Um gating muito conservador corre o risco de reconhecer a necessidade de adaptação tarde demais. Um gating sensível demais pode reativar mudanças frequentes e perder a economia esperada. Variar a intensidade e a velocidade dessa mudança é uma forma direta de testar o compromisso.
Há também informação rara. Uma classe pouco frequente pode contribuir pouco para a média e ainda ser decisiva para a aplicação. Propomos acompanhar desempenho por classe, frequência de ativação da atualização e intervalo desde a última mudança, para investigar se a seletividade concentra recursos de maneira útil ou reforça desequilíbrios do fluxo.
A ordem das tarefas merece o mesmo cuidado. Um regime pode se beneficiar de uma sequência em que representações se complementam e sofrer quando tarefas semelhantes exigem decisões incompatíveis. Repetições com permutações, novas sementes e níveis de ruído devem vir acompanhadas dos resultados individuais, permitindo observar variação em vez de apenas uma média final.
O contraste entre o regime completo e o gating isolado já fornece uma pergunta testável: quanto da retenção depende de consolidar pesos, quanto depende do pré-condicionamento e quanto da modulação interna? Uma ablação fatorial, com orçamento comparável de seleção de parâmetros, ajudaria a separar essas contribuições. Ela também deve contabilizar o armazenamento de estatísticas e o tempo de consolidação.
Por fim, passar de vetores sintéticos para entradas mais complexas pode deslocar o gargalo para a representação. Se o custo dominante estiver antes da etapa poupada, a relevância operacional da mesma taxa de saltos muda. Essa é uma razão para publicar o perfil de execução ao lado do resultado de aprendizagem.
9. Uma agenda de aprendizagem seletiva que pode ser refutada
O resultado atual sustenta uma investigação delimitada: nesta configuração sintética, a combinação de seleção de atualizações e mecanismos de retenção alcançou alta acurácia média final com poucas etapas de alteração dos pesos. O regime que mais poupou etapas, isoladamente, não foi o que melhor preservou as tarefas. Esse é um ponto de partida útil para projetar experimentos mais difíceis.
Uma próxima contribuição seria demonstrar que a relação entre qualidade e custo se mantém sob novas sementes, ordens e distribuições, com comparações mais amplas e medições físicas. Outra seria identificar condições em que o mecanismo falha: reconhecer esses casos ajuda a ajustar a hipótese e a escolher onde a abordagem tem utilidade.
Para a comunidade, a proposta é relatar eficiência com um denominador e um compromisso de qualidade. Quantas etapas foram evitadas? Qual trabalho permaneceu? O que foi retido? Quanto custou o sistema inteiro? Essas perguntas permitem comparar mecanismos sem converter automaticamente uma boa ideia algorítmica em uma afirmação ambiental.
Na página institucional da pesquisa estão o preprint, o código e o DOI do software. Reproduções que registrem hardware, versão, configuração e resultados completos podem transformar esse experimento inicial em evidência cumulativa. No terceiro artigo da série, a mesma atenção ao custo aparece em outra escala: as ações de um agente que precisa descobrir como um ambiente funciona.
Perguntas que continuam a conversa
93,47% de atualizações poupadas significa 93,47% menos eletricidade?
Não. A porcentagem divide etapas de atualização puladas pelas 6.000 apresentações. O sistema ainda executa previsões e mecanismos de controle. Uma estimativa de economia elétrica exige medições físicas e um escopo de comparação definido.
O experimento demonstra aprendizagem contínua em grades ARC?
Ele usa características sintéticas de 64 dimensões, cinco tarefas e uma rede pequena. O estudo estático em grades ARC é outro experimento do preprint. Os resultados precisam permanecer associados aos seus respectivos protocolos.
O que significa a métrica de esquecimento?
Na implementação publicada, é a média das quedas de acurácia, em pontos percentuais, entre o melhor valor registrado e o valor final das quatro tarefas anteriores. O relatório usa o nome forgetting_ratio_pct. Ela não representa a porcentagem de pesos esquecidos.
Houve novas medições para este artigo?
Não. O ensaio analisa o preprint e os artefatos do release v4.0.0. O controle interativo é um modelo contábil ilustrativo; as propostas de medição e robustez são uma agenda futura.
Fontes e referências
Literatura e documentação consultadas em 30 de outubro de 2026. Os resultados do F3-AGI são os reportados no preprint e nos registros do autor; não executamos uma nova rodada de benchmarks para este ensaio. Exemplos didáticos, interpretações e propostas de avaliação estão identificados no texto.
- James Kirkpatrick e colaboradoresOvercoming catastrophic forgetting in neural networks
Trabalho primário sobre EWC. Contexto para proteção de parâmetros importantes em aprendizagem sequencial.
- Henrique Oliveira / Polybee AI ResearchF3-AGI v4.0 — preprint
Manuscrito de 29/10/2026, sem revisão por pares. Seções 3.4 e 5.1, tabela 2. Os tempos ali publicados diferem dos registrados no JSON do release.
- Polybee AI Researchf3_metabolic_optim_results.json — release v4.0.0
Configuração, semente 42, métricas dos quatro regimes e tempos de execução do registro. Resultados produzidos pelo autor.
- Polybee AI Researchf3_metabolic_optim.py — implementação v4.0.0
Código para o fluxo sintético, gating, atualização dos parâmetros, consolidação e cálculo das métricas. Consultado para delimitar o significado dos contadores.
- Emma Strubell, Ananya Ganesh e Andrew McCallumEnergy and Policy Considerations for Deep Learning in NLP
Trabalho de 2019 sobre custos financeiros e ambientais de treinamento em NLP. Contexto geral, sem transferência de estimativas para o F3.
- Roy Schwartz, Jesse Dodge, Noah A. Smith e Oren EtzioniGreen AI
Trabalho de 2019 que propõe avaliar e reportar eficiência junto ao desempenho. O protocolo sugerido neste ensaio é uma proposta editorial própria.
- Polybee AI ResearchF3-AGI v4.0.0 — DOI do software
Identificador do artefato de software, conforme a referência do release. Não identifica a publicação do manuscrito no arXiv, que aguarda endosso.