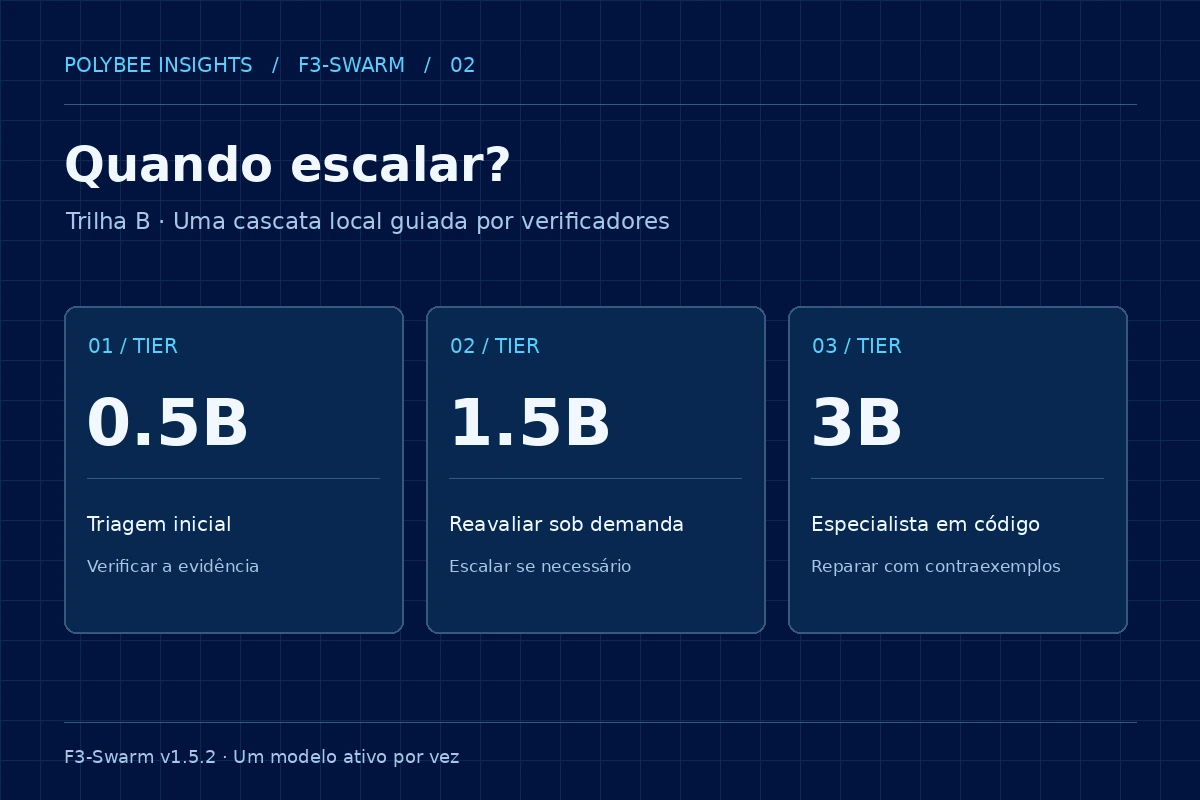
O F3-Swarm usa três modelos locais e verificadores adequados à tarefa. Em 30 tarefas em português, P4 foi mais rápida que o modelo 1,5B isolado; P5b acertou mais, mas aumentou o tempo total. A diferença ilustra por que uma política de escalonamento precisa ser avaliada junto com seus critérios de aceitação.
1. A decisão que a cascata precisa tomar
Considere uma triagem administrativa, uma extração de valor em reais e uma função Python. As três tarefas podem começar com o mesmo modelo, mas um sinal de qualidade para uma delas não se transfere automaticamente às demais. Na triagem interessa estabilidade da escolha; na extração, interessa rastrear o dado até o texto; no código, interessa o comportamento diante de entradas especificadas. Uma cascata só economiza trabalho quando sabe o que pode aceitar.
A Trilha B do F3-Swarm testa essa ideia em 30 tarefas em PT-BR: 12 de triagem, 10 de extração documental e 8 de síntese de funções. Os modelos Qwen2.5 de 0,5B, 1,5B e Coder 3B foram executados em CPU com carregamento sequencial. O limite abaixo de 1,5 GiB diz respeito aos dois primeiros níveis; o especialista foi reportado em 2,1 GB. Não é o consumo de três modelos simultâneos nem uma garantia de memória de ponta a ponta.
2. A confiança pode acompanhar a posição da opção
Se uma pergunta oferece duas respostas, o sistema pode atribuir peso à posição da opção. Um teste simples troca a ordem, remapeia os rótulos e verifica se a escolha semântica se manteve. Comparar apenas a letra antes e depois não basta: se a opção correta muda de A para B, a decisão estável também precisa mudar de letra. Uma inconsistência é motivo para pedir mais evidência.
No protótipo, a calibração de logits e o teste de inversão ajudam na triagem. Alguns casos escalados usam uma justificativa curta e um fechamento controlado da saída. São medidas com papéis diferentes: remapear opções avalia sensibilidade à ordem; limitar e fechar a saída ajuda a obter uma resposta processável. Nenhuma dessas medidas garante que a classificação final corresponda ao caso real.
3. Extrair um trecho e interpretar um valor são tarefas diferentes
Um documento pode conter subtotal, imposto e valor final no mesmo parágrafo. Pedir ao modelo um número válido é insuficiente: qualquer um dos três passa no teste de formato. Vale exigir o trecho de origem e uma regra para identificar o campo. No F3-Swarm, o Motor B verifica que a evidência textual está na fonte e normaliza a moeda em PT-BR de forma determinística.
Por exemplo, “R$ 1.234,56” pode virar 123456 centavos em uma representação de inteiros. O exemplo é didático: guardar centavos evita confundir ponto de milhar com ponto decimal e preserva uma unidade para cálculos. A evidência confirma a presença do valor, mas ainda é preciso verificar se ele corresponde ao campo solicitado. Valores duplicados ou contexto ambíguo podem exigir revisão.
4. A falha deve informar a próxima tentativa
Para síntese de funções, o protótipo verifica quatro exemplos de desenvolvimento. Quando o código falha, o reparo recebe o contraexemplo: entrada, saída esperada e saída produzida. A informação especifica um comportamento que precisa mudar. Reenviar apenas “tente novamente” desperdiça a oportunidade de explicar a falha, enquanto reenviar toda a suíte de avaliação pode comprometer a independência da medição.
Exemplo didático
O sinal muda a próxima ação
A classificação ficou sensível à ordem. Peça nova avaliação; confiança alta na primeira resposta não resolve a inconsistência.
Ilustração de regras de decisão. Nenhum modelo é executado aqui.
5. O que se perde ao errar a decisão de aceitar
Um verificador pode cometer dois tipos de erro operacional: aceitar uma saída incorreta ou escalar uma saída que já estava correta. O primeiro põe um resultado ruim em circulação. O segundo aumenta custo e latência, e pode ainda substituir uma boa solução por uma ruim. Medir somente a porcentagem de saídas aceitas não distingue esses casos.
Imagine 100 solicitações de extração: o primeiro nível aceita 80 e quatro delas estão erradas. Nesse cenário didático, cobertura inicial é 80%; o erro entre as respostas aceitas é 5%. Trocar o limiar pode reduzir os quatro erros e aumentar a fila de revisão. A escolha depende das consequências de cada erro, da capacidade de revisão e do prazo de resposta. O estudo não fixa um limiar universal para esse compromisso.
6. A política mais precisa também pode levar mais tempo
| Política | Acertos | Tempo total |
|---|---|---|
| P1 · 0,5B fixo | 12/30 · 40,0% | 57,76 s |
| P2 · 1,5B fixo | 22/30 · 73,3% | 111,18 s |
| P3 · Cascata inicial | 19/30 · 63,3% | 96,21 s |
| P4 · Swarm v1.0 | 23/30 · 76,7% | 84,70 s |
| P5a · Diagnóstico sem ajustes | 27/30 · 90,0% | 119,07 s |
| P5b · Versão ajustada | 29/30 · 96,7% | 121,19 s |
P4 obteve 23 acertos, um a mais que P2, e levou 84,70 s frente a 111,18 s: redução de 23,8% no tempo total reportado. P5b chegou a 29/30 com 121,19 s, cerca de 9,0% a mais que P2. O nível 3 foi acionado em três tarefas. Esses são resultados do conjunto usado no desenvolvimento, não uma prova de vantagem estatística para todo fluxo operacional.
A consolidação da P5 reutilizou registros de tarefas já resolvidas e acrescentou execuções de casos selecionados. P5a preservou o diagnóstico anterior; P5b ajustou o orçamento de saída e o fechamento, corrigiu resultados esperados de T26 e incluiu uma dica de algoritmo no reparo dessa tarefa. O ganho entre variantes não isola a contribuição de cada mudança. O ensaio sobre generalização desta série examina separadamente o código anterior à dica.
7. Como saber qual peça melhorou a política
Comparar duas linhas da tabela é o começo da investigação. Para atribuir uma melhora à inversão de opções, por exemplo, avalie o mesmo modelo nas mesmas tarefas, com e sem inversão, mantendo o restante fixo. Para avaliar a normalização, registre quantas saídas já indicavam a evidência correta e quantas mudaram após a regra determinística. Para avaliar o especialista, compare soluções antes e depois do reparo sem alterar simultaneamente o oráculo.
Também é útil comparar os erros em pares. Dois sistemas com 22 e 23 acertos podem errar quase todas as mesmas tarefas ou falhar em grupos muito diferentes. A matriz por tarefa mostra quais casos a política corrigiu e quais regrediram. Em um conjunto pequeno, essa inspeção informa o próximo experimento melhor do que atribuir significado geral a um acerto de diferença.
8. Conte também a espera, as revisões e os erros
Em uma cascata, uma solicitação escalada paga pelo primeiro modelo, pelo verificador e pela etapa seguinte. Há ainda troca de processos, carregamento de pesos e possíveis repetições. A proporção de solicitações que passa pelo caminho caro pode mudar com o tráfego. Uma média global oculta se o usuário típico recebe resposta rápida ou se uma classe de casos fica presa em várias tentativas.
Para avaliar custos, registre tempo de cada etapa, taxa de escalonamento por tipo de tarefa, p95 e frequência de revisões humanas. Some o custo de uma aceitação errada e o custo de uma escalada desnecessária. A energia reportada no preprint foi estimada assumindo potência de CPU, sem medição elétrica direta; não transforme essa estimativa em promessa de economia de uma instalação.
9. Um contrato para cada saída
Para triagem, guarde a categoria, o conjunto de opções, as decisões após remapeamento e o motivo de eventual abstenção. Para extração, guarde o campo, o valor normalizado, a unidade e o trecho de origem. Para código, guarde a função selecionada, a versão da suíte e os contraexemplos usados no reparo. Esses registros permitem comparar políticas sem tratar texto fluente como evidência de correção.
Defina ainda o que acontece quando todos os níveis falham. Um fluxo pode retornar “evidência insuficiente”, pedir um documento mais legível ou enviar o caso a revisão. Inclua esses resultados na avaliação: o número de casos concluídos não deve esconder atrasos, desistências ou encaminhamentos. Um piloto é mais útil quando revela onde a política deve se abster do que quando força uma saída para cada entrada.
10. Como levar a ideia a um fluxo próprio
Comece com uma tarefa cuja evidência seja explícita. Defina o que constitui aceitação, falha e abstenção antes de escolher modelos. Colete casos representativos com resultados esperados revisados, separe desenvolvimento de avaliação e compare com uma regra determinística e um modelo fixo. Use as mesmas entradas, os mesmos critérios e os mesmos limites de execução nas comparações.
Depois, registre a justificativa do roteamento: opção instável, evidência ausente, teste reprovado ou limite de tempo. Observe a taxa de erros entre respostas aceitas, não apenas a porcentagem resolvida no primeiro nível. Reserve revisão humana para decisões de maior impacto e repita a avaliação quando o formato dos documentos ou o perfil das tarefas mudar. Assim a cascata pode ser ajustada com sinais do fluxo real, sem depender de um número agregado do laboratório.
Perguntas que continuam a conversa
O modelo maior sempre melhora a resposta?
Não. O tamanho não substitui testes específicos; no estudo, há casos em que o candidato menor generaliza melhor.
O que significa carregar um modelo por vez?
Cada nível ativo ocupa memória durante sua execução. Escalar pode exigir descarregar um modelo e carregar outro.
Por que P5b não é simplesmente mais rápida?
Reparos e escalonamentos adicionam trabalho. P5b teve mais acertos, mas levou mais tempo que o baseline P2.
A normalização resolve toda a extração documental?
Não. Ela torna a representação de moeda consistente; selecionar a evidência do campo correto é uma etapa separada.
Fontes e referências
As fontes abaixo documentam os experimentos. Exemplos didáticos são identificados separadamente das medições.
- Polybee AI ResearchF3-Swarm v1.5.2 · preprint técnico
Manuscrito, desenho experimental e limitações.
- ZenodoF3-Swarm v1.5.2 · DOI 10.5281/zenodo.24095260
Registro persistente da pesquisa.
- Polybee AI Researchlab05_tier3_closure_results.json
Registros da consolidação e da variante de diagnóstico.
- Polybee AI ResearchREADME · F3-Swarm v1.5.2
Descrição das políticas, arquitetura e resultados por classe.