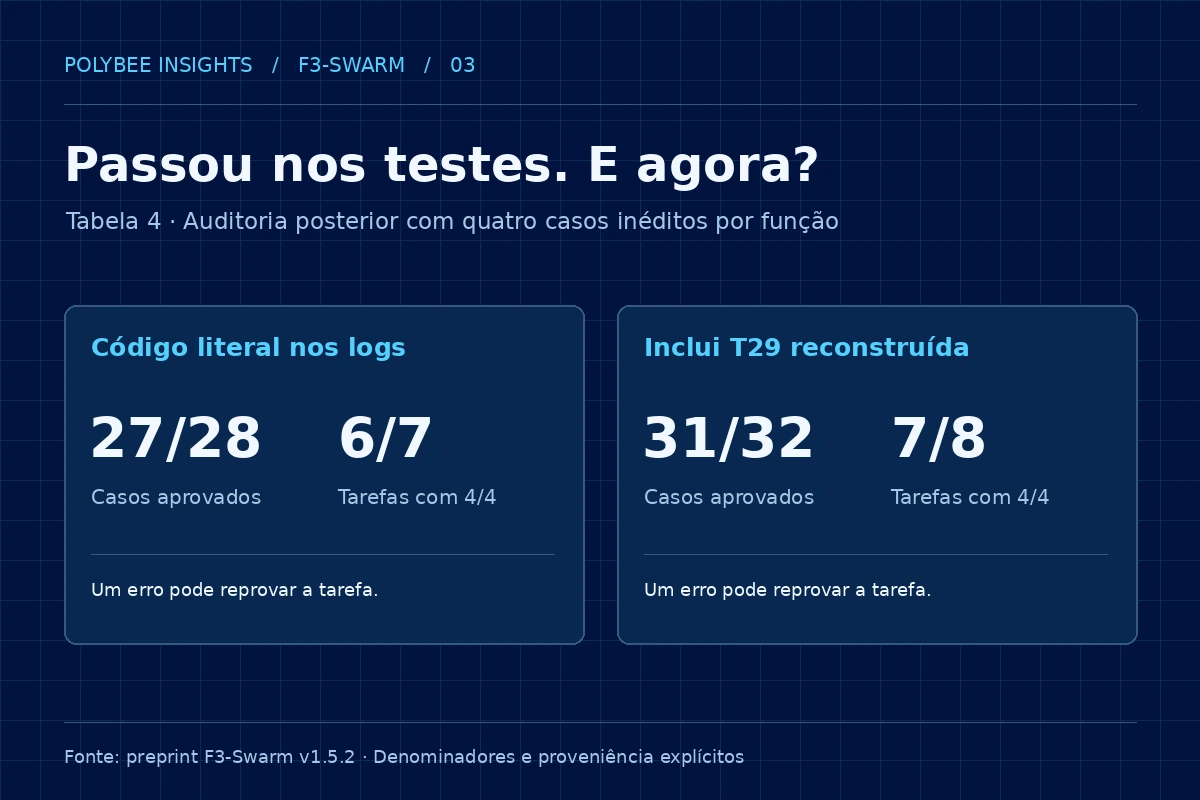
Na auditoria posterior do F3-Swarm, as funções preservadas literalmente nos logs acertaram 27 de 28 casos inéditos, mas apenas 6 de 7 tarefas passaram em todos os casos. Incluir uma função reconstruída muda os denominadores. A diferença é central para interpretar o agregado de 28/30 e desenhar avaliações melhores.
1. Passar em exemplos é evidência, não uma especificação
Duas funções podem devolver as mesmas respostas para quatro entradas e divergir na quinta. A primeira pode implementar a regra pretendida; a segunda pode reconhecer apenas o formato ou um padrão acidental dos exemplos. O verificador não distingue as duas se o conjunto de testes não contiver uma entrada em que seus comportamentos se separem. Essa multiplicidade de soluções compatíveis com a evidência disponível é a questão central.
O F3-Swarm usou quatro testes de desenvolvimento por tarefa de código para aceitar, reparar ou escalar uma solução. Esses testes são úteis como barreira inicial e fonte de contraexemplos. Quando a entrada, a saída esperada e a saída produzida são usadas no reparo, o caso passa a fazer parte do processo de desenvolvimento. Ele continua útil como regressão, mas perde o papel de evidência independente de generalização.
2. O que um caso de fronteira revela
Na tarefa T27, de interpretação de datas brasileiras, uma solução usava o analisador de datas da biblioteca padrão e outra reconhecia o formato com expressão regular. Ambas passaram nos exemplos visíveis depois do ajuste no ambiente de execução. Datas inexistentes, como 29/02/2025 e 31/04/2026, revelaram a diferença: reconhecer DD/MM/AAAA não valida o calendário. Na auditoria, o candidato de 0,5B passou 4/4; o de 1,5B passou 2/4.
Na tarefa T25, de higienização de chave PIX, um código aprovado no desenvolvimento extraía os dígitos e, se encontrasse onze, tratava a entrada como CPF. Uma chave aleatória alfanumérica com onze dígitos expôs o defeito: retirar letras destrói parte do identificador. O candidato passou três de quatro casos inéditos, mas a tarefa foi reprovada. O exemplo mostra o valor de testar entradas que atravessam o limite entre categorias.
3. Escolha casos que separem hipóteses
Quando duas implementações acertam os exemplos conhecidos, pergunte onde suas hipóteses divergem. Para datas, varie calendário, limites de mês e anos bissextos, além da forma da string. Para identificadores, teste entradas cuja aparência superficial se pareça com a de outra classe. Para regras por faixa, use o ponto exato da transição, um valor abaixo e outro acima. Cada caso deve ter uma razão para estar ali.
É possível acrescentar relações entre entradas e saídas, além de valores esperados isolados. Por exemplo, uma normalização válida pode precisar preservar o resultado ao ser aplicada duas vezes; acrescentar espaços externos pode não mudar a interpretação de um identificador se a especificação permitir. Essas propriedades são hipóteses de teste: verifique primeiro se pertencem ao contrato. Mais testes não ajudam se repetem a mesma distinção ou impõem uma regra que a tarefa não exige.
4. O resultado esperado também pode estar errado
Um teste compara o comportamento da função com um oráculo: a regra ou o valor esperado. Se a referência está incorreta, uma implementação correta pode receber uma reprovação. No caso de módulo 11 (T26), o preprint documenta dois valores esperados incorretos nos testes originais. A versão ajustada P5b corrigiu o oráculo e adicionou uma dica de algoritmo ao prompt. Seria fácil atribuir todo o ganho ao modelo ou à dica se essas mudanças aparecessem como uma única linha de resultado.
A auditoria recuperou o código de 3B registrado antes da dica e o avaliou em quatro entradas inéditas. Ele passou as quatro. Isso dá evidência sobre aquela função original e aqueles casos; não prova que toda tentativa sem dica encontrará a mesma solução. Quando uma referência mudar, mantenha a anterior, documente a justificativa e separe a reavaliação do mesmo código da geração de um novo candidato.
5. Código registrado e reconstrução são evidências diferentes
Para sete tarefas, o código avaliado pôde ser recuperado literalmente dos logs. Na T29, o registro informava o resultado, mas não serializava o código da função selecionada. A auditoria inclui uma reconstrução separadamente. Guardar essa distinção é importante porque reproduzir o comportamento esperado com uma função reconstruída não prova que ela era a função que rodou na primeira vez.
| Recorte | Casos aprovados | Tarefas com 4/4 |
|---|---|---|
| Código literal nos logs | 27/28 · 96,4% | 6/7 · 85,7% |
| Inclui T29 reconstruída | 31/32 · 96,9% | 7/8 · 87,5% |
Explore a Tabela 4
Escolha o recorte da auditoria
A visualização usa os totais publicados; não executa as funções.
Os totais respondem a perguntas diferentes. 27/28 mede casos individuais no recorte literal; 6/7 mede tarefas aprovadas em todos os quatro casos. Com T29, esses totais passam a 31/32 e 7/8. Uma única falha tem peso diferente nos dois denominadores, e os quatro casos de uma função não são quatro tarefas independentes. Por isso, uma taxa por caso não pode substituir a taxa por tarefa.
6. Como interpretar 29/30 e 28/30
O 29/30 da P5b (96,7%) é o desempenho no conjunto de desenvolvimento. O 28/30 ajustado (93,3%) soma 11/12 de triagem e 10/10 de extração do conjunto original a 7/8 de funções aprovadas na auditoria posterior, incluindo T29 reconstruída. Só o componente de código foi reavaliado com casos inéditos. A redação precisa é “agregado ajustado pela auditoria de código”.
O intervalo de Wilson reportado para 28/30 é 78,7%–98,2%. Ele ajuda a mostrar a escala da incerteza numérica, mas não corrige as escolhas do desenho: casos elaborados depois do desenvolvimento, classes avaliadas de maneiras diferentes e dependência de uma reconstrução. A auditoria testa se funções já selecionadas resistem a novos casos; não mede o desempenho em um conjunto externo de trinta tarefas inéditas.
7. Inédito para a função não significa definido de antemão
Os casos da auditoria foram formulados depois dos Labs 01–05. As funções preservadas já existiam e não foram reparadas usando esses novos casos para a medição reportada. Isso torna a auditoria informativa sobre vulnerabilidades de candidatos já selecionados. Ao mesmo tempo, a escolha posterior dos casos não equivale a uma amostra aleatória do uso futuro ou a um protocolo de avaliação congelado antes do desenvolvimento.
Em uma próxima rodada, defina previamente as famílias de casos e as regras de pontuação, mantenha os dados ocultos e guarde um recorte externo de tarefas novas. Relate separadamente resultados exploratórios, resultados de uma avaliação pré-especificada e regressões depois do reparo. Isso evita que um número reusado em contextos distintos passe a responder a perguntas para as quais o teste não foi desenhado.
8. Como projetar uma auditoria mais forte
Antes de gerar código, registre a regra que cada tarefa deve implementar e decida quais resultados são aceitáveis. Escreva casos normais e de fronteira; revise os esperados com uma referência independente. Reserve um conjunto oculto que não seja mostrado ao modelo nem aos responsáveis pelo reparo. Sempre que um caso oculto voltar ao prompt, mova-o para o conjunto de regressão e renove o conjunto que mede generalização.
Preserve o código exato escolhido, seu hash, a versão do modelo, o prompt, a configuração e o resultado de cada teste. A trilha deve permitir reproduzir a avaliação do mesmo artefato sem gerar outra resposta. Registre separadamente mudanças no código e no oráculo. Quando houver dados ausentes, declare o recorte observado e reporte reconstruções em uma linha própria.
9. O que publicar junto ao percentual
Um relatório reproduzível começa pela pergunta: a unidade de sucesso é um caso, uma função, uma tarefa ou um fluxo inteiro? Depois informa quantos candidatos foram gerados e quantos passaram no desenvolvimento, quais eram elegíveis para auditoria e por que algum ficou de fora. Nas tabelas, coloque numerador e denominador junto ao percentual. Dê a cada versão de teste e a cada referência um identificador.
Sempre que possível, publique também os contraexemplos que causaram reprovação, a proveniência das funções e a configuração necessária para repetir a pontuação. Uma coluna “código literal”, “reconstruído” ou “indisponível” ajuda o leitor a separar evidência direta de interpretação. Em caso de divergência, outro pesquisador deve conseguir apontar se o desacordo está no artefato, no oráculo ou no critério de contagem.
10. Correção funcional não é isolamento de execução
Uma função pode produzir a saída correta e ainda fazer coisas fora do contrato: consumir recursos excessivos, ler arquivos ou tentar acessar a rede. Os quatro testes observam respostas; o executor do protótipo não oferece isolamento de segurança para código não confiável. Usar o mesmo namespace em Python resolve um problema de execução do laboratório, não limita permissões do processo.
Se a decisão for executar código gerado, avalie também limites de CPU, memória e tempo, acesso a arquivos e rede, e critérios de interrupção. Faça a avaliação de segurança separadamente da acurácia. A lição do estudo é tratar aceitação como uma decisão apoiada por evidência identificável: exemplos de desenvolvimento, casos inéditos e condições de execução respondem a perguntas diferentes.
Perguntas que continuam a conversa
27/28 e 6/7 são contraditórios?
Não. Um mede casos; o outro exige quatro acertos para aprovar cada tarefa.
O agregado de 28/30 é inteiramente fora da amostra?
Não. Combina resultados originais de triagem e extração com a auditoria de funções.
Por que apresentar T29 separadamente?
O código exato não foi serializado no log. A reconstrução tem uma proveniência diferente.
Passar em todos os casos garante segurança?
Não. Acurácia funcional e isolamento do ambiente precisam de avaliações próprias.
Fontes e referências
As fontes abaixo documentam os experimentos. Exemplos didáticos são identificados separadamente das medições.
- Polybee AI ResearchF3-Swarm v1.5.2 · preprint técnico
Manuscrito, desenho experimental e limitações.
- ZenodoF3-Swarm v1.5.2 · DOI 10.5281/zenodo.24095260
Registro persistente da pesquisa.
- Polybee AI Researchreproduce_all_results.py
Script com recortes, regras de contagem e auditoria posterior.
- Polybee AI Researchprecise_tier3_results.json
Registro do código do especialista antes do ajuste.
- Polybee AI Researchlab04_aacr_results.json
Registros da cascata, incluindo a origem dos dados da T29.