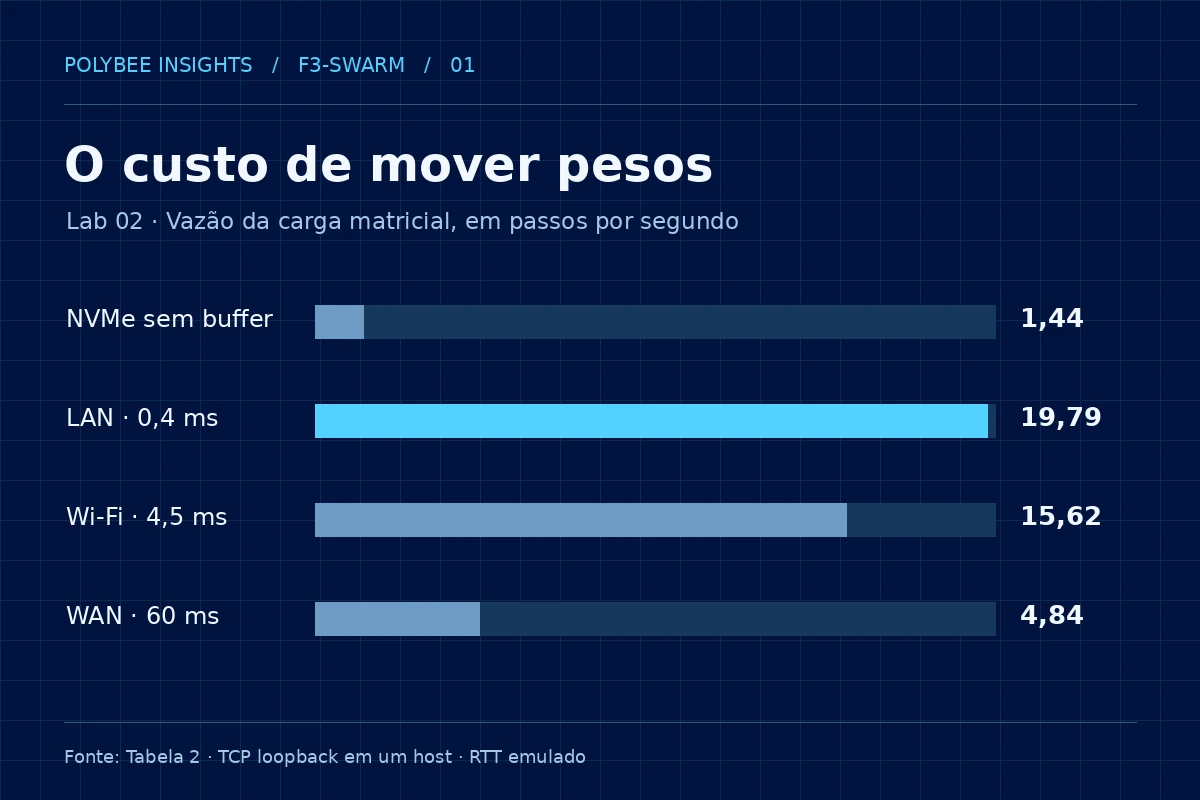
O Lab 02 comparou leitura repetida de matrizes a partir do NVMe com três processos que mantinham os pesos em RAM. No cenário de menor latência emulada, a vazão passou de 1,44 para 19,79 passos por segundo. O resultado pertence a uma carga matricial controlada e ajuda a formular testes para modelos completos.
1. O gargalo pode estar antes da multiplicação
O tamanho de um modelo diz quanto espaço seus pesos ocupam, mas não descreve o trajeto que esses pesos fazem durante a execução. Se uma camada não estiver em memória quando chega sua vez, o sistema precisa buscá-la. Repetir essa transferência a cada passo transforma um custo de carregamento em um custo de operação. Uma CPU rápida ainda pode passar grande parte do tempo esperando dados.
O inventário do Lab 01 registrou 15,788 GiB de RAM física e 2,789 GiB livres no momento da medição. Esse instantâneo motiva o problema; não é a quantidade fixa de memória que qualquer computador de 16 GB disponibiliza. O Lab 02 criou um limite reproduzível por processo para comparar duas formas de acomodar uma carga de 1,50 GiB.
2. O que foi comparado
A carga era formada por 24 camadas densas de 4.096 × 4.096 em float32, com projeções, normalização e ativações ao longo de 32 passos. Cada camada ocupava 64 MiB. O Windows impunha 600 MiB de working set por processo. No braço SSD, um processo mantinha oito camadas residentes e lia as 16 restantes com I/O sem buffer, evitando que o cache de arquivos escondesse o custo da leitura repetida.
No braço residente, três processos mantinham oito camadas cada e passavam vetores de ativação de 16 KiB via TCP em 127.0.0.1. Os working sets medidos ficavam entre 529,5 e 546,8 MiB por trabalhador. Isso contorna o teto por processo usando mais RAM agregada: a soma dos três working sets foi aproximadamente 1,57 GiB. Não houve redução equivalente no tamanho dos pesos.
3. O que os números medem
| Condição | RTT emulado | Passos/s | Tempo total | Leitura de SSD |
|---|---|---|---|---|
| NVMe sem buffer | — | 1,44 | 22,16 s | 33,00 GiB |
| Loopback LAN | 0,4 ms | 19,79 | 1,62 s | 0 GiB |
| Loopback Wi-Fi | 4,5 ms | 15,62 | 2,05 s | 0 GiB |
| Loopback WAN | 60 ms | 4,84 | 6,61 s | 0 GiB |
A telemetria registrou 33,00 GiB de leitura no SSD e zero nos cenários residentes durante a comparação. Esse volume é medido no ensaio; multiplicar apenas o tamanho nominal das camadas transmitidas pelo número de passos produz uma conta simplificada, não substitui o registro de I/O. O artigo também registrou diferença numérica máxima de 0,0 entre as saídas comparadas.
A unidade útil aqui é passo por segundo. O preprint apresenta vazão com o rótulo tok/s, mas o objeto medido não é a geração de texto por um LLM. Também vale usar a razão reportada de 13,70×, pois dividir os valores já arredondados da tabela dá uma aproximação diferente. A paridade numérica se refere a esse cálculo e a essas condições.
4. O tamanho do que se move explica a aposta
Na configuração SSD, dezesseis camadas de 64 MiB correspondem a 1.024 MiB de pesos lidos nominalmente por passo. Na divisão em três estágios, há duas passagens de um vetor de 16 KiB por passo: 32 KiB de dados úteis, antes de cabeçalhos, controle e cópias. Essa conta de ordem de grandeza explica por que manter pesos no estágio pode funcionar. Ela compara objetos diferentes e não pretende reproduzir os contadores de disco e rede.
Volume pequeno não implica espera pequena. Se o próximo estágio não pode começar até receber o vetor, o atraso pode se repetir no caminho crítico a cada passo. A vazão depende tanto de bytes por segundo quanto de quando cada mensagem libera trabalho. Para identificar a causa de lentidão, cronometre leitura, cálculo, serialização, envio e espera pelo próximo estágio separadamente.
5. Separar preparação, primeiro passo e vazão
O tempo até o primeiro resultado e o custo médio dos passos seguintes respondem a perguntas diferentes. Uma interação curta pode sentir mais a preparação dos processos; uma carga longa pode amortizá-la. O cálculo abaixo usa as duas vazões reportadas apenas para ilustrar esse ponto. Ele não reproduz a telemetria, não estima o carregamento real e não extrapola para um servidor de produção.
Exemplo didático
Quando vale pagar pela preparação?
Imagine dois caminhos: SSD a 1,44 passo/s e pesos residentes a 19,79 passos/s, com 2 s hipotéticos para preparar os processos residentes. A conta é tempo fixo + passos ÷ vazão. A preparação de 2 s é ilustrativa e não faz parte da Tabela 2.
No exemplo, um passo demora mais com a preparação de 2 s; a partir de quatro passos a vantagem da vazão já compensa. Alterar o custo fixo ou introduzir concorrência desloca esse ponto. Em um teste aplicado, use tempos observados de inicialização fria e aquecida, registre repetições e mantenha o comprimento do lote explícito.
6. Primeiro resultado e ritmo sustentado
Além da vazão, a Tabela 2 registra 715,30 ms até o primeiro resultado no braço SSD e 95,33 ms no cenário LAN emulado. Os tempos por passo seguintes reportados são 692,58 ms e 50,54 ms. Na condição Wi-Fi emulada, o primeiro resultado reportado é de 59,54 ms, embora a vazão total seja menor que na LAN emulada. Comparar só um desses números pode levar a uma conclusão diferente da comparação de toda a execução.
Não há razão para tratar a ordem desses tempos iniciais como uma propriedade geral de Wi-Fi ou LAN: são observações de loopback com atraso injetado. Um protocolo mais forte controla o estado inicial e informa mediana e dispersão entre repetições. Para uma aplicação interativa, a primeira saída e o intervalo entre saídas merecem limites separados. Para um processamento em lote, o tempo total por unidade concluída pode ser o principal critério.
7. O que o loopback permite isolar
Os atrasos de 0,4, 4,5 e 60 ms foram injetados por software. Isso permite variar a espera mantendo constantes a máquina, a carga e a organização dos processos. A queda de 19,79 para 4,84 passos/s mostra sensibilidade ao atraso nesse pipeline. Os rótulos LAN, Wi-Fi e WAN representam perfis emulados, sem medição de uma rede física.
Em uma rede real, dois caminhos com o mesmo RTT médio podem ter efeitos distintos. Jitter e retransmissões penalizam os estágios que precisam esperar pelo estágio anterior. A largura de banda afeta mensagens maiores; o tamanho de ativação observado aqui não descreve todos os lotes e arquiteturas. Além disso, memória, CPU e disco de hosts diferentes podem alterar o gargalo. É por isso que a média do loopback não serve como promessa de desempenho em rede.
8. Qual comparação responde à decisão de engenharia?
Se a pergunta for sobre movimento de pesos, manter a aritmética e a saída constantes ajuda a isolar o custo de acesso. Se for sobre a melhor implantação para um serviço, o conjunto de comparações muda. Inclua, quando couber, um único processo com pesos residentes, uma versão quantizada que caiba em RAM e o pipeline com vários trabalhadores. O ganho frente ao SSD não determina o vencedor entre essas alternativas.
Registre quantos recursos cada configuração consome em conjunto. Comparar só o maior working set por processo oculta o uso agregado de RAM; comparar só a vazão ignora o primeiro resultado e a variabilidade. Para inferência real, registre configuração do modelo, quantização, tamanho de contexto, batch e cache KV. Fixe as entradas e verifique equivalência numérica ou de qualidade conforme o caso.
9. Capacidade, paralelismo e disponibilidade
Particionar um modelo pode resolver um problema de capacidade mesmo quando não melhora o tempo de uma solicitação. Um pipeline divide a residência dos pesos; para uma única solicitação, suas dependências continuam sequenciais. Atender várias solicitações pode mudar a utilização dos estágios, mas também adiciona filas e precisa de uma política para limites de memória e de concorrência. Por isso, registre throughput do serviço e latência por solicitação como métricas separadas.
O teste em uma máquina também não revela o que ocorre quando um trabalhador fica indisponível. Em uma implementação física, teste falhas, reconexão e a alternativa de execução local, sob o mesmo orçamento e com entradas equivalentes. Um ganho de tempo em execução saudável pode deixar de compensar quando a transferência falha com frequência ou quando o custo de manter hosts disponíveis supera o benefício.
10. Um protocolo para sair do laboratório
Primeiro reproduza o controle de um host com os dados e a configuração registrados. Depois, separe os trabalhadores em dois ou mais hosts, preserve a operação medida e altere uma condição por vez. Observe leitura de SSD, memória residente total, bytes transferidos e tempos por estágio. Reporte tanto os tempos frios quanto os aquecidos e distribuições de latência, incluindo p95, em vez de só a melhor repetição.
Por fim, execute um modelo completo com atenção, embeddings e cache, medindo tokens e qualidade com a mesma configuração de referência. Esse passo testa uma hipótese nova. A cascata de modelos do F3-Swarm foi avaliada localmente em outra trilha; o benchmark de matrizes não integrou essa cascata a uma rede multi-host. A contribuição desta trilha é mostrar em quais condições medidas o custo de movimentação muda a escolha de arquitetura.
Perguntas que continuam a conversa
O ganho de 13,70× vale para geração de texto?
Não foi medido em geração de texto. Vale para a vazão da carga matricial frente ao SSD sem buffer, a 0,4 ms de RTT emulado.
A técnica economiza RAM total?
O ensaio redistribui os pesos por processos. A comparação não demonstra redução de RAM agregada.
O SSD pode ser a melhor opção?
Pode, conforme memória disponível, preparação, reutilização da carga e objetivos de latência. É preciso medir a configuração de interesse.
O que falta para afirmar ganho em uma rede real?
Executar em hosts separados e medir rede, variação, memória total e qualidade com um modelo completo e baselines comparáveis.
Fontes e referências
As fontes abaixo documentam os experimentos. Exemplos didáticos são identificados separadamente das medições.
- Polybee AI ResearchF3-Swarm v1.5.2 · preprint técnico
Manuscrito, desenho experimental e limitações.
- ZenodoF3-Swarm v1.5.2 · DOI 10.5281/zenodo.24095260
Registro persistente da pesquisa.
- Polybee AI Researchlab02_physical_results.json
Telemetria utilizada na Tabela 2.
- Polybee AI Researchf3_swarm_lab02_physical_test.py
Implementação da comparação de memória.